
Schatten-KI
Verträge, Kundendaten und Quellcode landen in privaten Chatbot-Konten — an jeder Richtlinie, jedem Vertrag und jedem Auftragsverarbeitungsvertrag vorbei.
AIMan von brandcompete
Ihre Mitarbeitenden wollen Claude, GPT und Gemini — am liebsten heute. Ihre IT muss wissen, wohin Unternehmensdaten fließen. AIMan gibt beiden Seiten, was sie brauchen: eine Anmeldung für die führenden Modelle und für offene Modelle auf unseren eigenen GPU-Servern in Deutschland — mit Antworten aus Ihren Dokumenten und dem Web.
Sensible Arbeit bleibt in Deutschland. Offene Modelle und die gesamte Dokumentensuche laufen auf dedizierten GPU-Servern — unseren oder, on-premise, Ihren. Die Modelle der Anbieter sind nur einen Reiter entfernt, wenn eine Aufgabe sie braucht.
Anmeldung für alle, mit Ihrem Microsoft- oder Google-Arbeitskonto
offene Modellfamilien auf dedizierten GPU-Servern in Deutschland
Anbieter mit gehosteten Modellen, unter den eigenen Schlüsseln Ihres Unternehmens
private KI-Konten, die Ihre Mitarbeitenden für ihre Arbeit brauchen
Die Ausgangslage
KI zu verbieten funktioniert nicht. Alle machen zu lassen, wie sie wollen, aber auch nicht. Beides kostet mehr, als es auf den ersten Blick scheint.
Verträge, Kundendaten und Quellcode landen in privaten Chatbot-Konten — an jeder Richtlinie, jedem Vertrag und jedem Auftragsverarbeitungsvertrag vorbei.
Hier ein ChatGPT-Abo, dort eine Copilot-Lizenz, anderswo ein Gemini-Test: getrennte Verträge, Rechnungen und Regeln — und niemand hat den Gesamtüberblick.
Ein Modell, das weder Ihre Dokumente noch die Nachrichten von heute kennt, rät — und zwar sehr überzeugend. Ohne Quellen kann niemand prüfen, was es behauptet.
Die Lösung
AIMan bündelt alle Modelle hinter einer Anmeldung und einer Oberfläche, stützt die Antworten auf Ihr Wissen und das Web und gibt der IT einen zentralen Ort, an dem sie festlegt, wer was nutzt.
Claude, GPT, Gemini, Cohere und elf offene Modellfamilien in einer Auswahl. Wählen Sie pro Chat — oder pro Tab, und vergleichen Sie.
Mistral NeMo, Qwen, Gemma, gpt-oss, Phi und DeepSeek auf dedizierten GPU-Servern. Prompts an diese Modelle bleiben dort. Keine Kosten pro Token.
PDFs, Office-Dateien, Webseiten, Confluence, Jira und Bitbucket als Datenquellen. Jede Antwort nennt Dokument und Seite.
Ein Schalter pro Chat für aktuelle Antworten, die Quellen stehen darunter. Anbietermodelle nutzen die Suche ihres Anbieters, offene Modelle unsere.
Reasoning-Modelle denken Schritt für Schritt nach, bevor sie antworten — live mitzulesen und danach eingeklappt.
Ein gemeinsames Prompt Repository mit Platzhaltern, Kategorien und Tags, dazu Custom Instructions für dauerhaften Kontext.
Gemeinsame Chats mit Kolleginnen und Kollegen, Teams oder einer ganzen Abteilung. Datenquellen, Prompts und Anweisungen werden genauso geteilt.
Exportieren Sie einen Chat-Tab — Modell, Datenquelle, Anweisungen — als Chatbot für das Intranet oder eine Anwendung.
Übersetzung mit DeepL, Bilder für Vision-Modelle, Dateianhänge und jede Antwort mit einem Klick kopiert.
Admins schalten Modelle und Versionen frei oder ziehen sie zurück, ordnen die Auswahl und sehen, was auf welchem GPU-Server geladen ist.
SSO mit Microsoft und Google, Rollen, Organisationseinheiten und Teams — und alle Anbieterschlüssel zentral verwahrt, nicht bei Einzelnen.
Eine modellunabhängige REST-API mit gestreamten Antworten. Jedes freigeschaltete Modell per Name aufrufen; das Modell wechseln, ohne den Code zu ändern.
So funktioniert es
Niemand muss wissen, welcher Anbieter hinter welchem Modell steckt. Die Entscheidungen des Unternehmens — welche Modelle, welche Schlüssel, welche Daten — trifft die IT einmal, zentral.
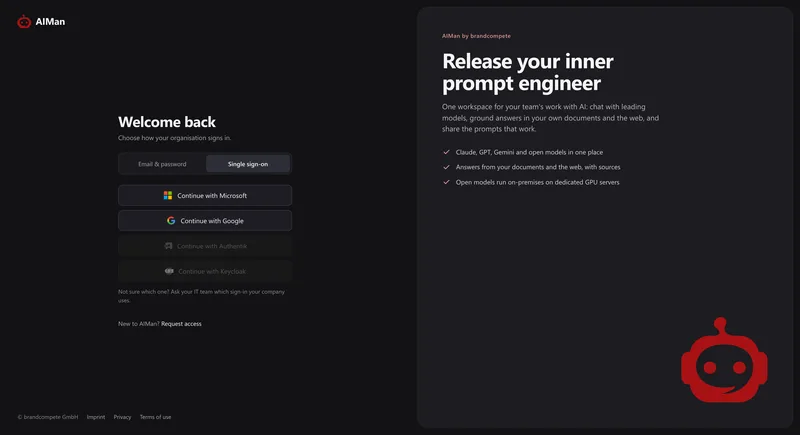
Mit dem Microsoft- oder Google-Arbeitskonto, das ohnehin alle haben, oder mit E-Mail und Passwort. Hinein kommt nur, wer zu Ihren Domains gehört.
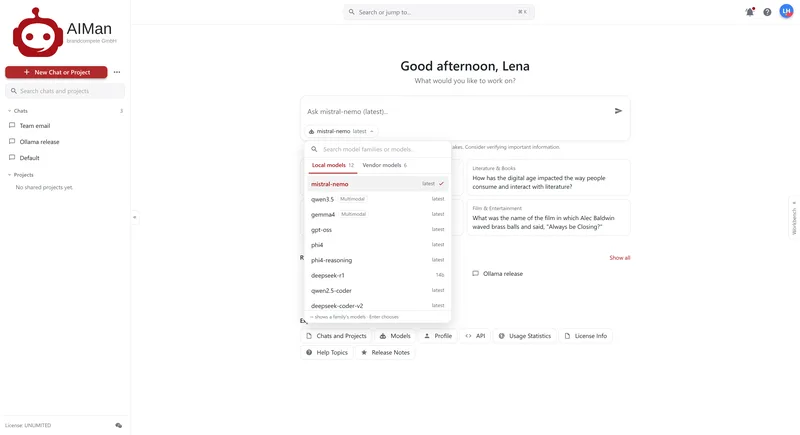
Lokale Modelle auf unseren GPUs oder die Modelle der Anbieter im zweiten Reiter. mistral-nemo ist voreingestellt — einfach lostippen.
Verknüpfen Sie eine Datenquelle — Dateien, Webseiten, Confluence — oder schalten Sie die Websuche ein. Die Antwort nennt, worauf sie sich stützt.
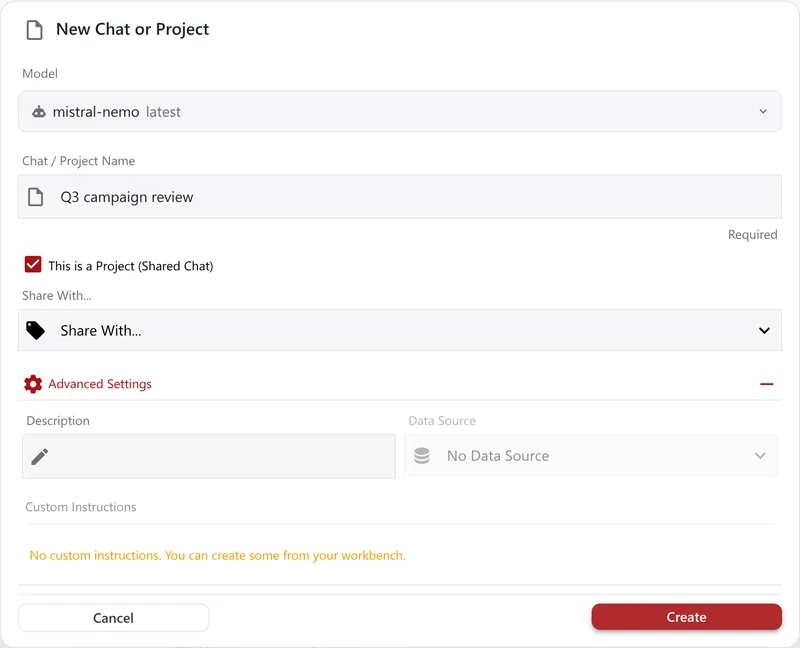
Machen Sie daraus ein Projekt fürs Team, speichern Sie den Prompt im Repository oder exportieren Sie den Tab als Chatbot.
Hinter jedem Schritt: Die Assistenten-Anweisung des Unternehmens geht an jedes Modell, das heutige Datum inklusive; die Rolle einer Person entscheidet, was sie anlegen darf; und was sie anlegt, bleibt privat, bis sie es teilt.
Das Produkt
Bildschirme aus dem laufenden Produkt, dessen Oberfläche englischsprachig ist. Klicken Sie auf ein Bild, um es in voller Größe zu sehen.
Tippen Sie einfach auf der Startseite los, oder öffnen Sie einen Chat und wählen Sie ein Modell. Offene Modelle auf unseren eigenen GPU-Servern und die gehosteten Modelle der Anbieter stehen in derselben Modellauswahl, auf zwei Reitern, und antworten in derselben Oberfläche.
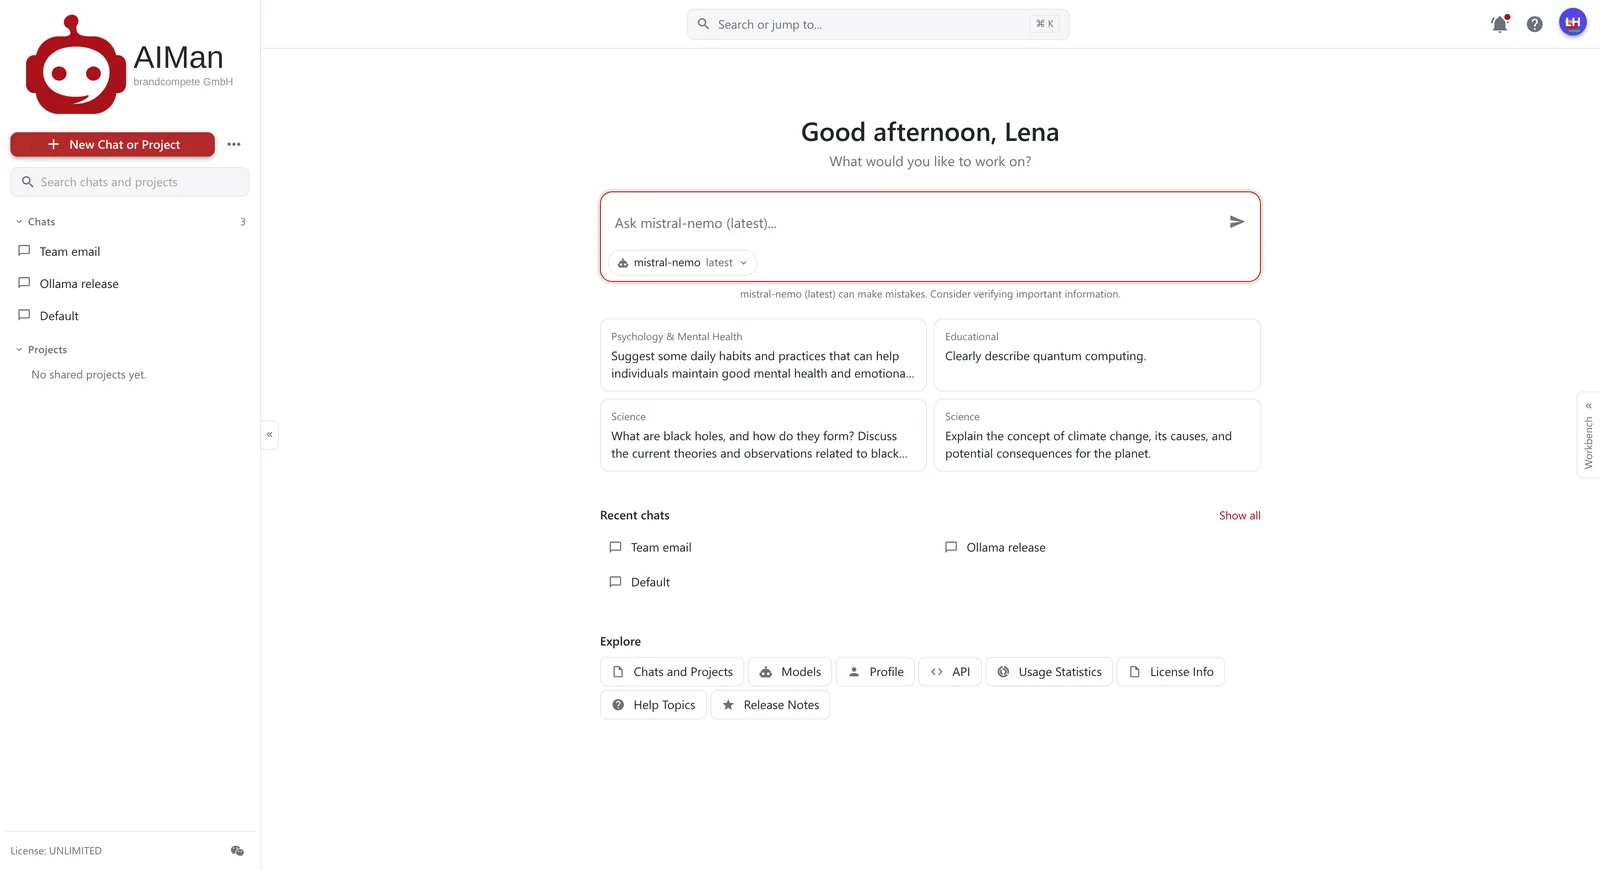
Die Startseite: tippen und loslegen.
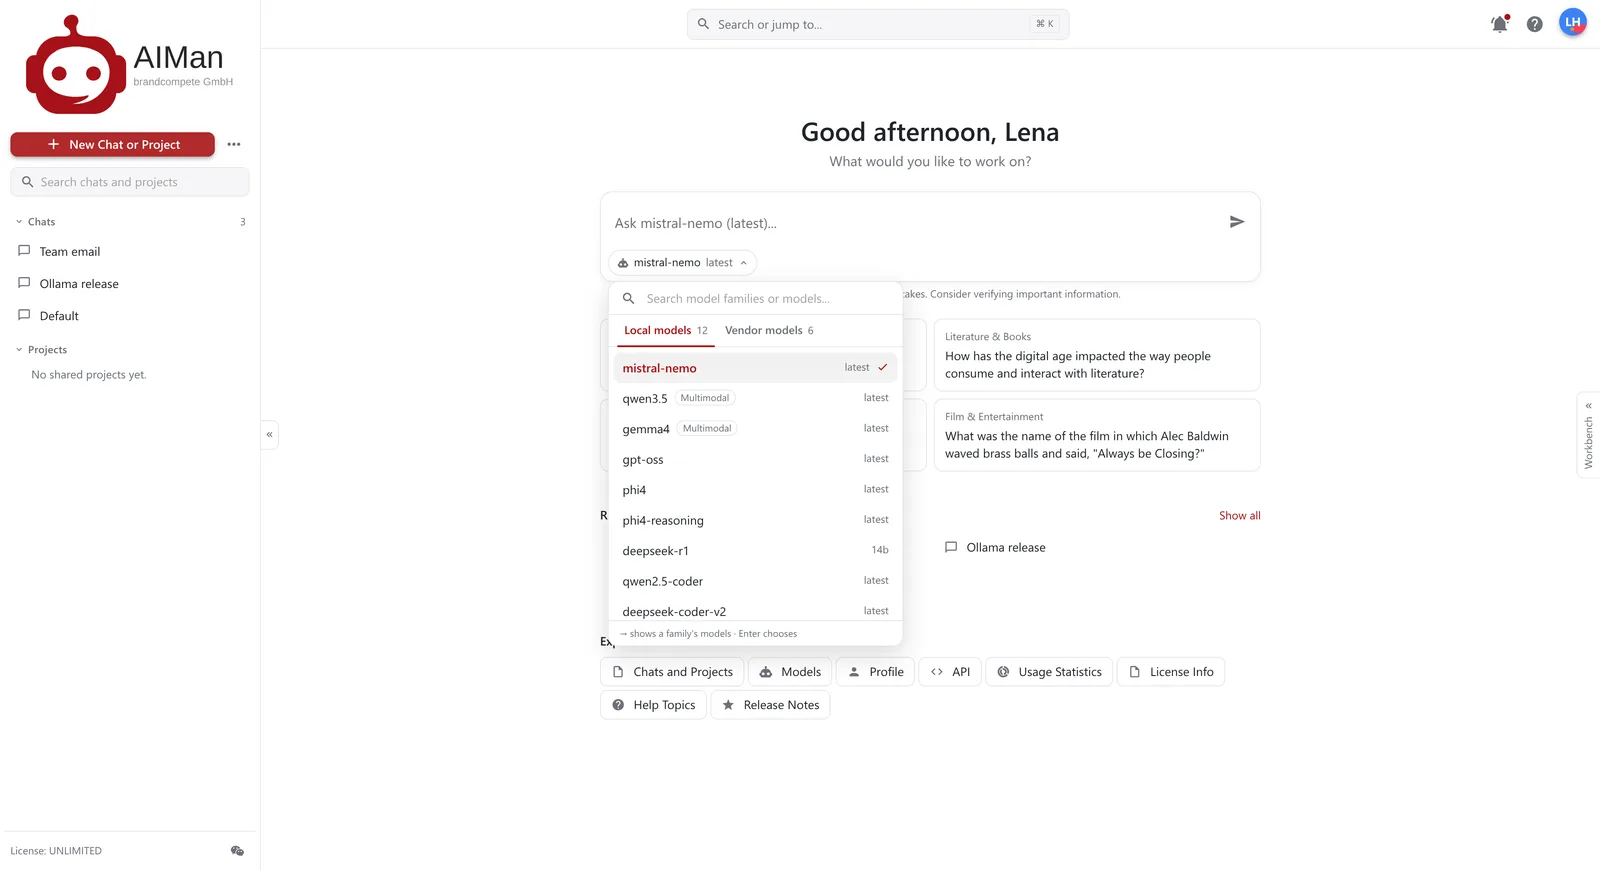
Offene Modelle auf unseren GPU-Servern.
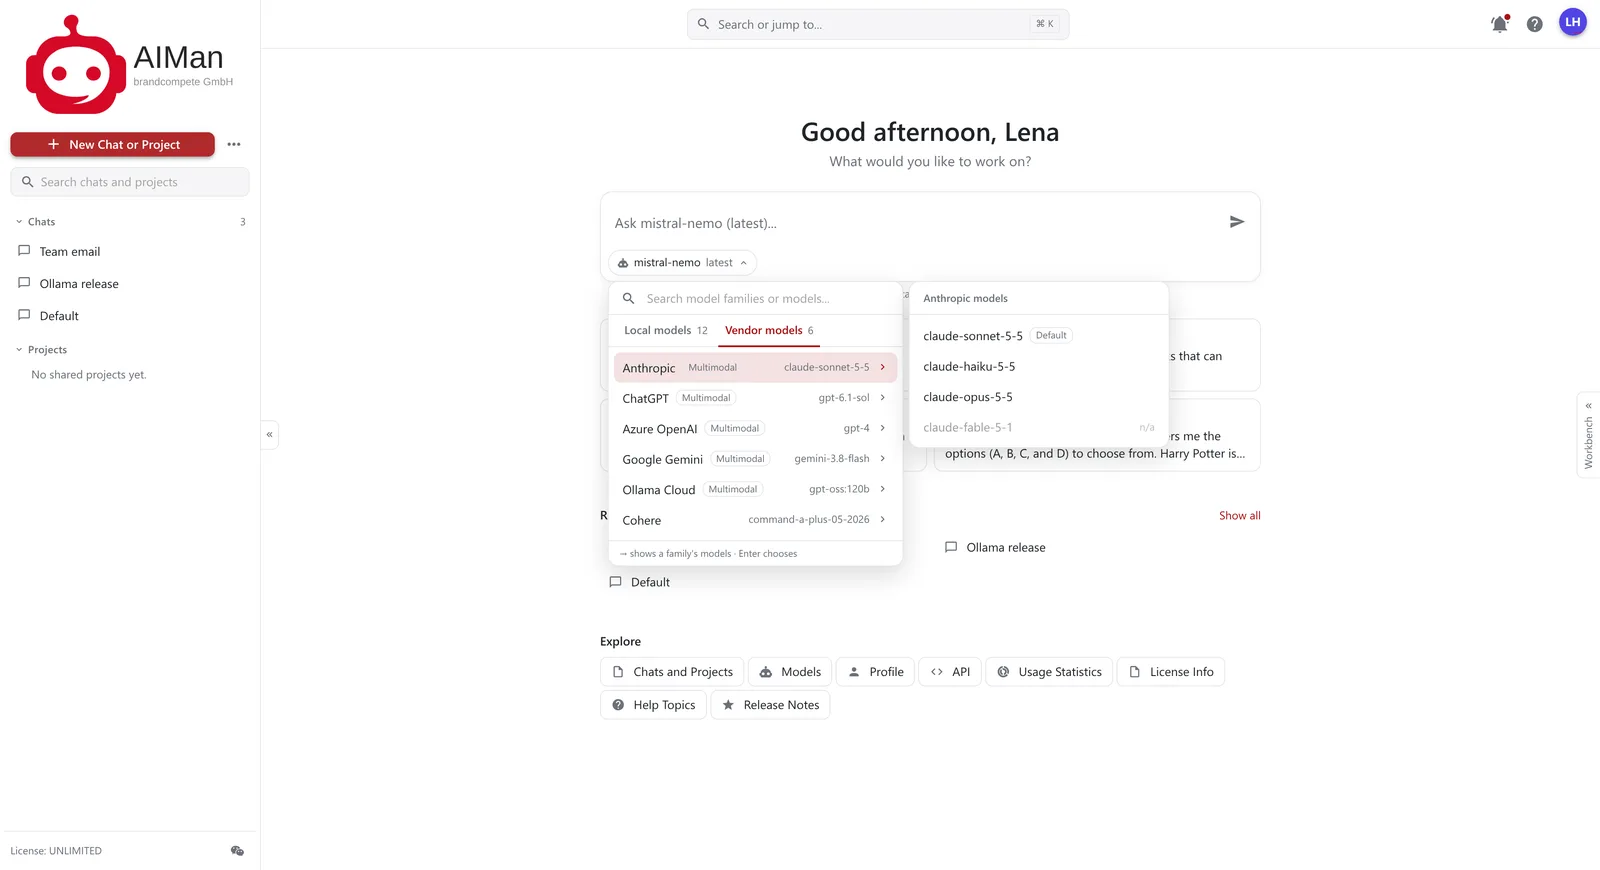
Claude, GPT, Gemini und mehr.
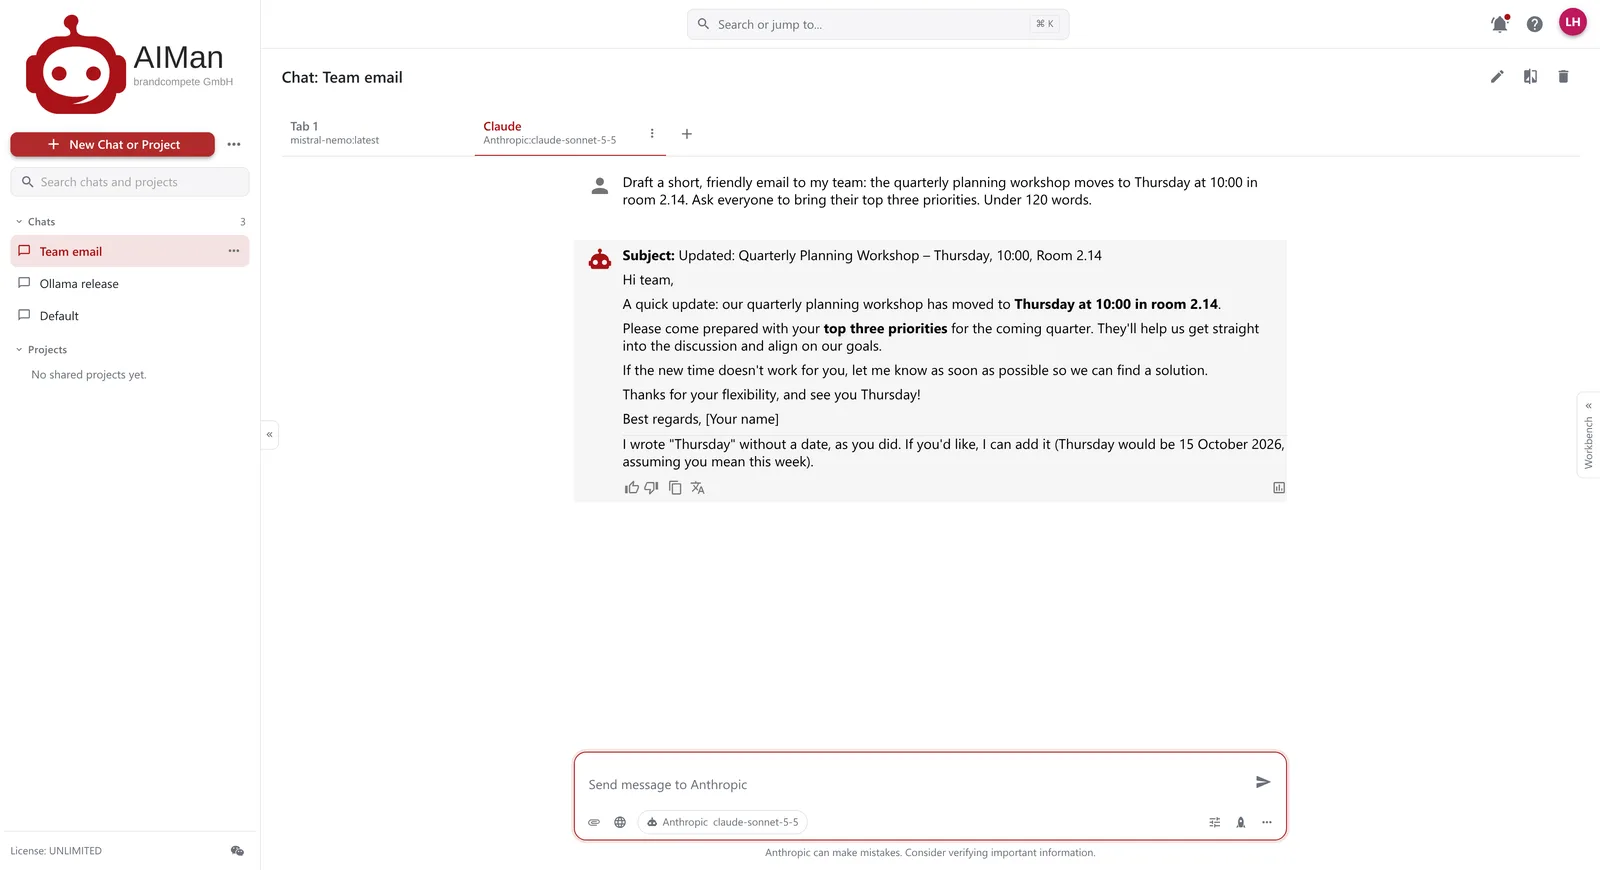
Derselbe Prompt, beantwortet von Claude.
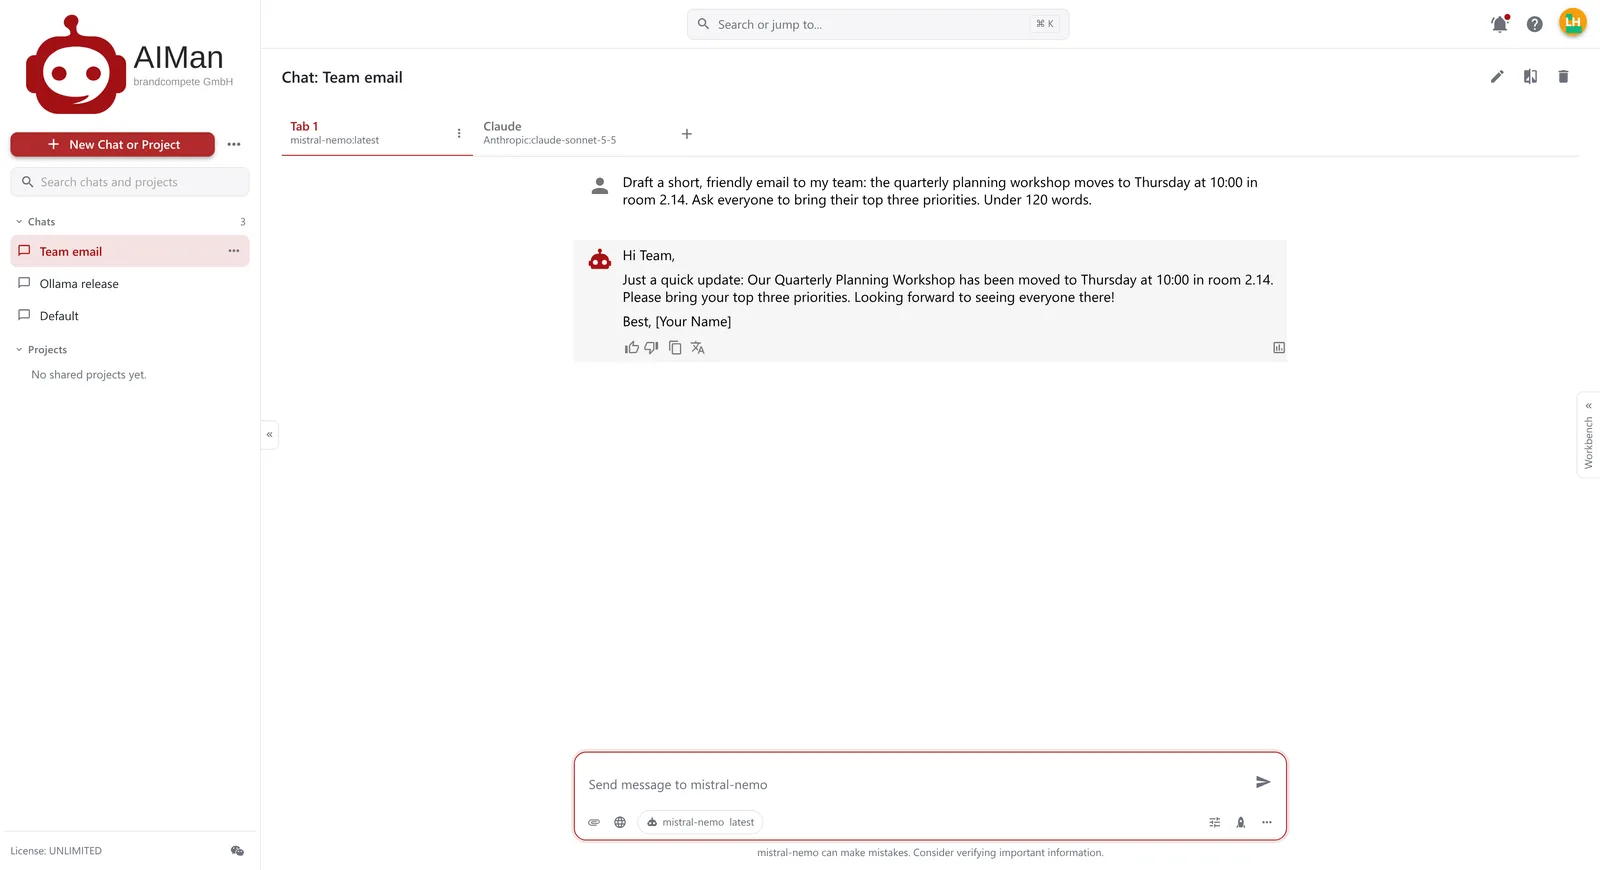
… und von mistral-nemo, auf unseren eigenen GPUs.
Schalten Sie für einen Chat die Websuche („Web search“) ein, und die Antwort stützt sich auf aktuelle Seiten: jede Aussage nummeriert, die Quellen darunter aufgelistet. Claude, Gemini und GPT nutzen die Suche ihres Anbieters, offene Modelle suchen über AIMan.
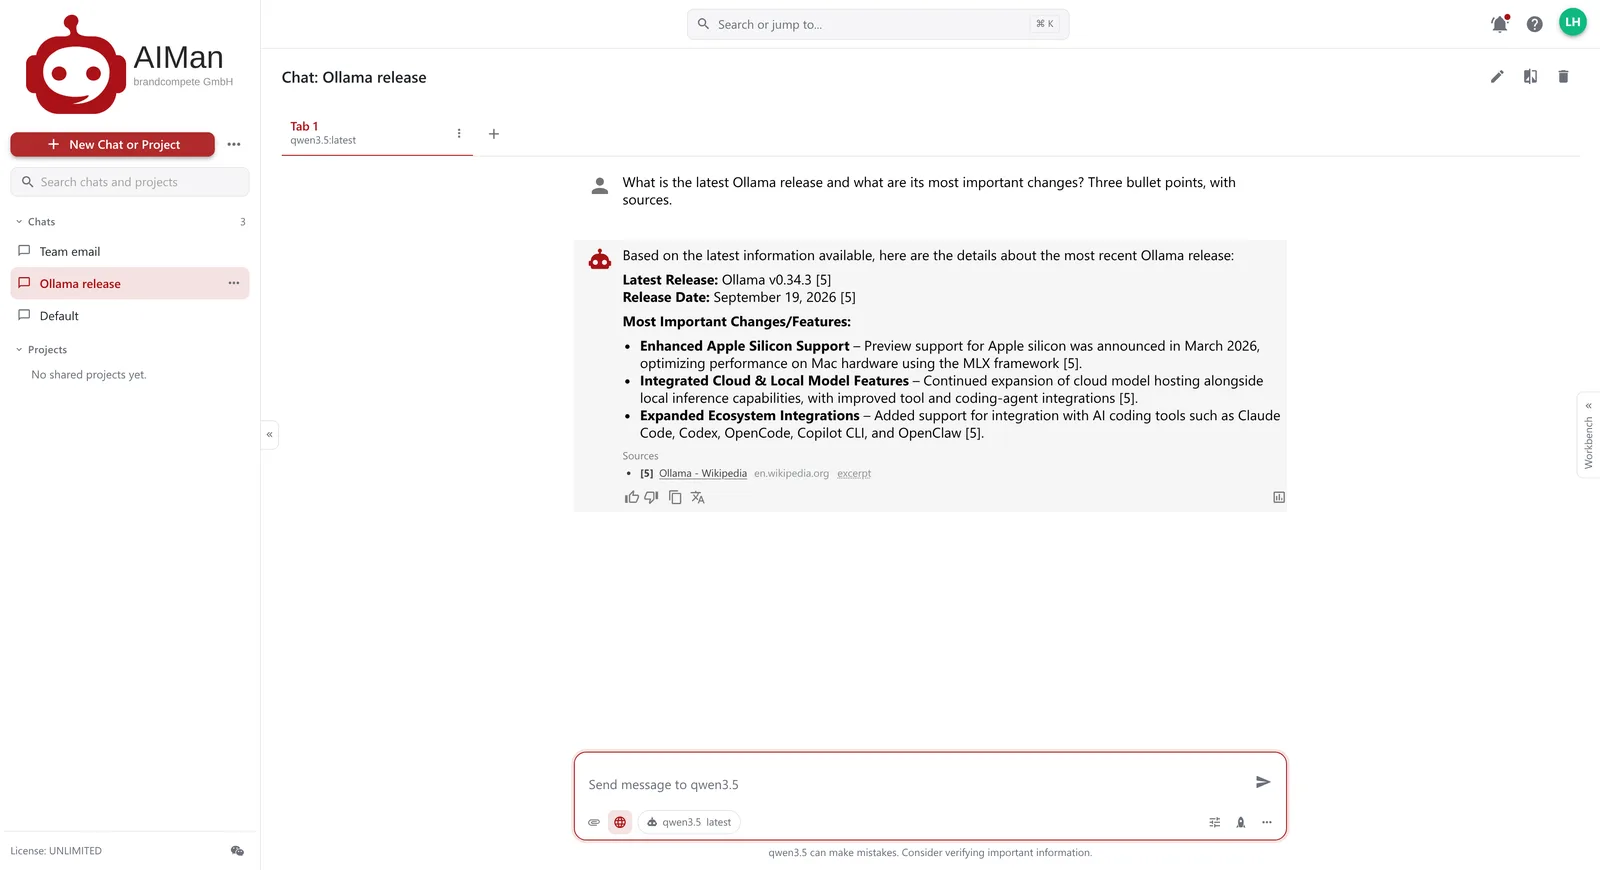
Eine Web-Antwort mit Quelle.
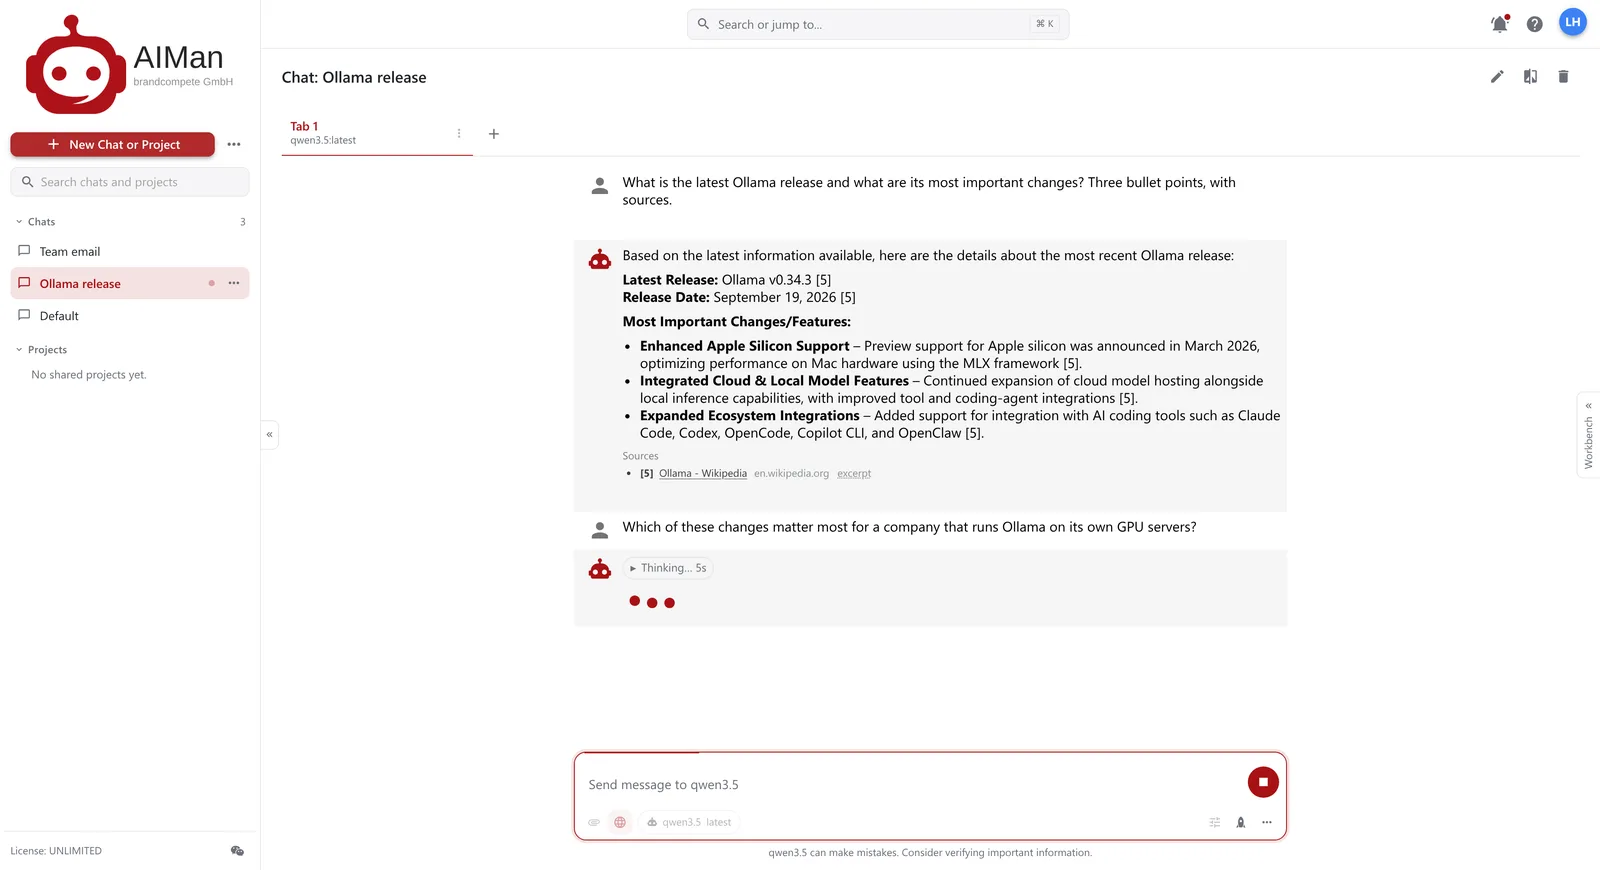
Das Modell denkt nach, bevor es antwortet.
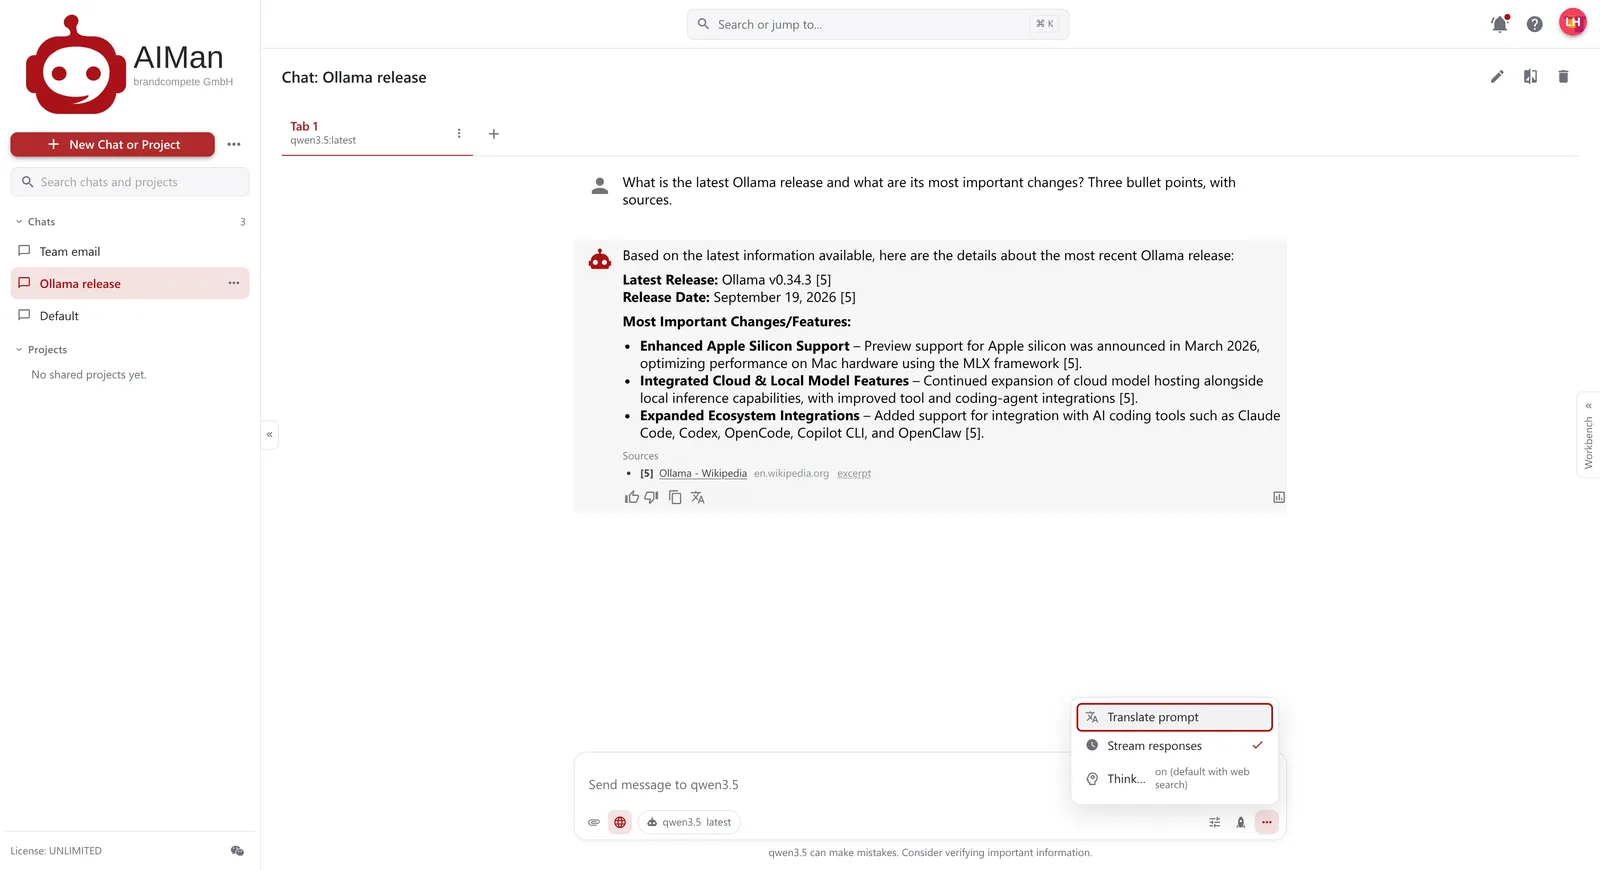
Thinking an — bei Websuche automatisch.
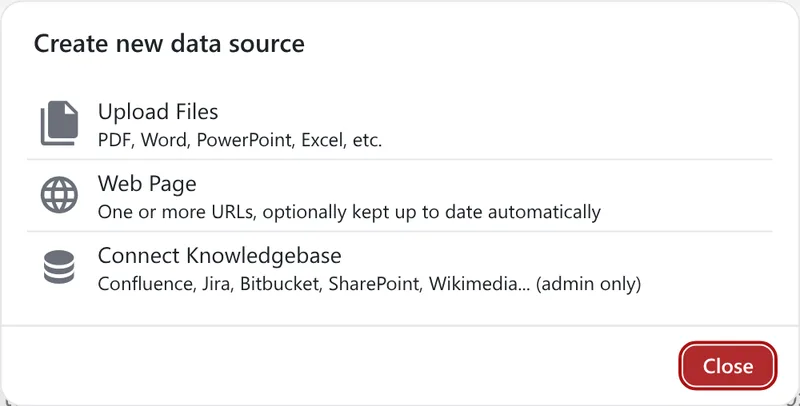
Laden Sie Dokumente hoch, binden Sie Webseiten oder ein Unternehmenswiki an und verknüpfen Sie die Datenquelle mit einem Chat. Jede Antwort entsteht aus den passendsten Textstellen und nennt sie, mit Dokument und Seite. Nichts Passendes dabei? Dann sagt AIMan das, statt zu raten.
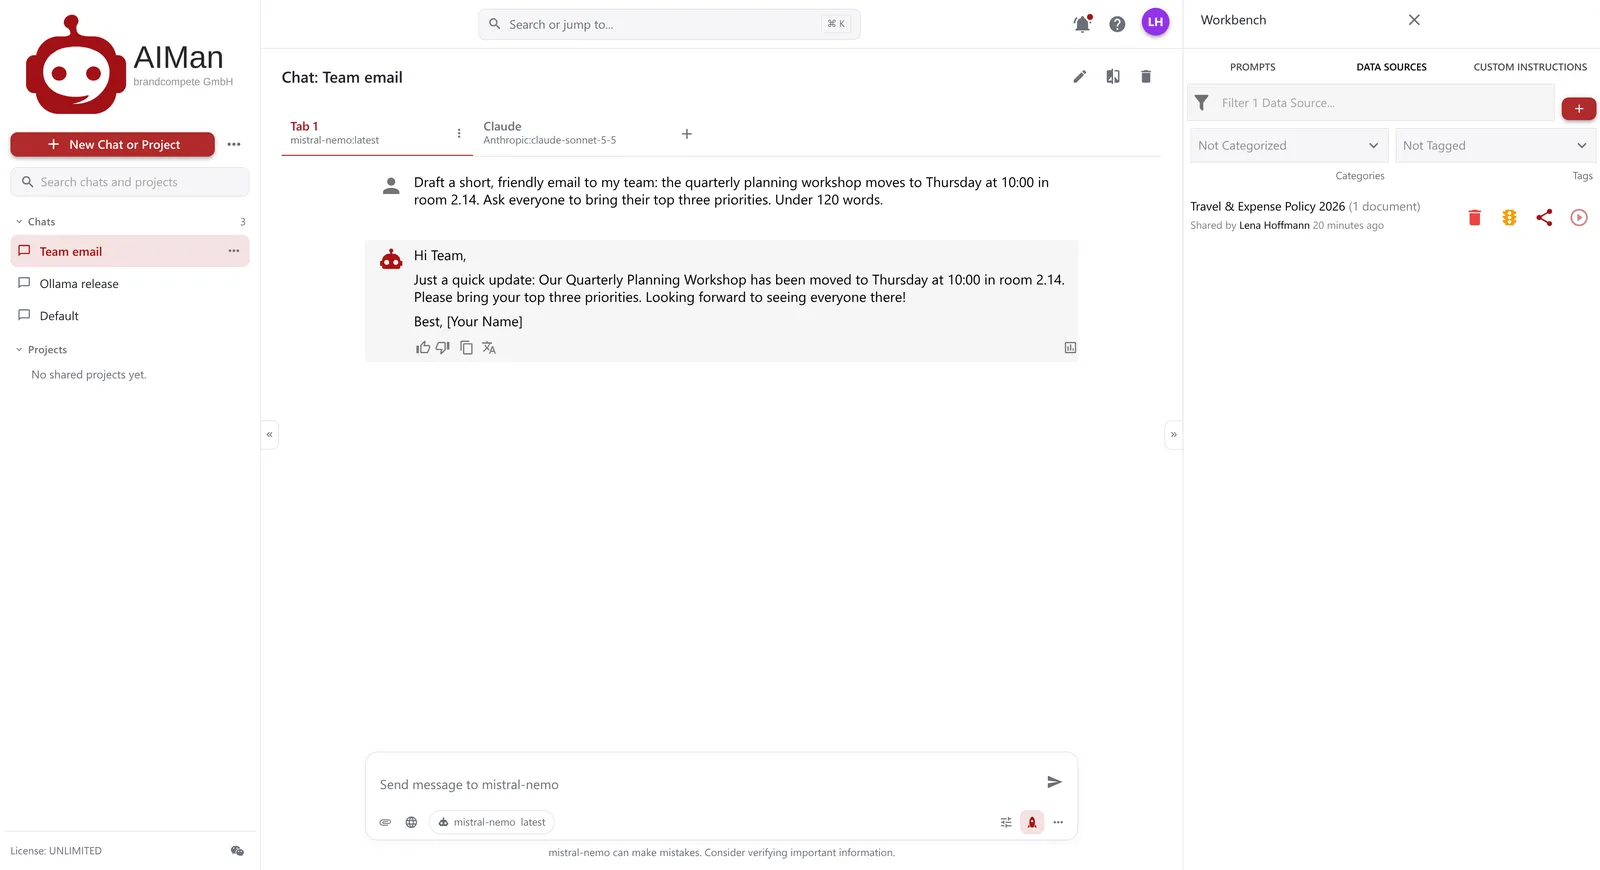
Ihre Datenquellen, in der Workbench.
Dateien, Webseiten oder eine Wissensbasis.
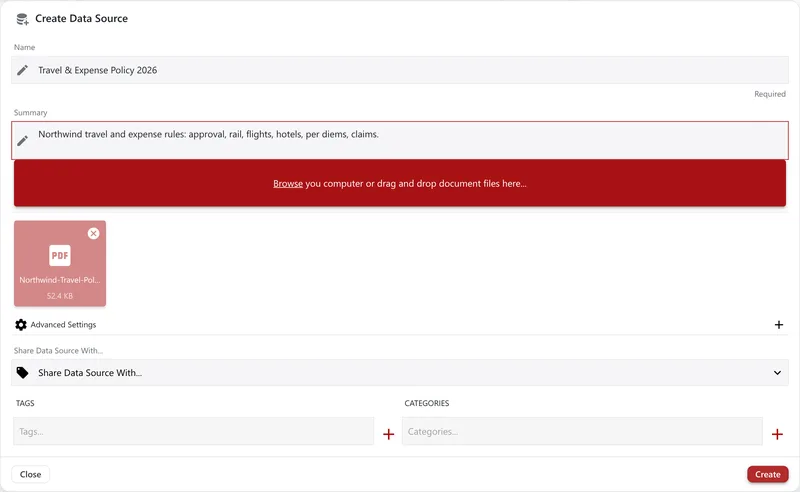
Ein PDF, ein Name, eine Zusammenfassung.
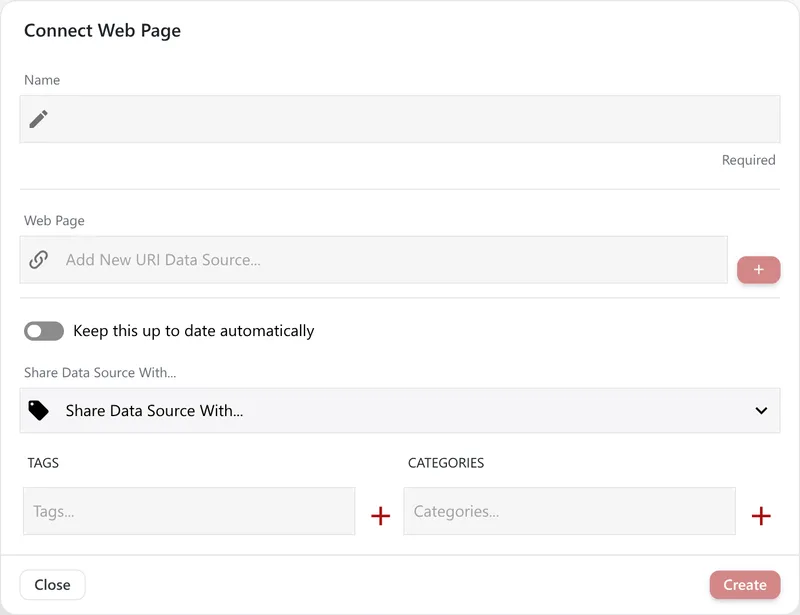
Webseiten, stets aktuell.
Speichern Sie einen guten Prompt im Prompt Repository, mit {{Platzhaltern}} für die Teile, die sich ändern, und starten Sie ihn jederzeit wieder aus der Workbench neben jedem Chat. Custom Instructions geben dauerhaften Kontext mit — Ihre Rolle, Ihren Ton, Ihre Begriffe.
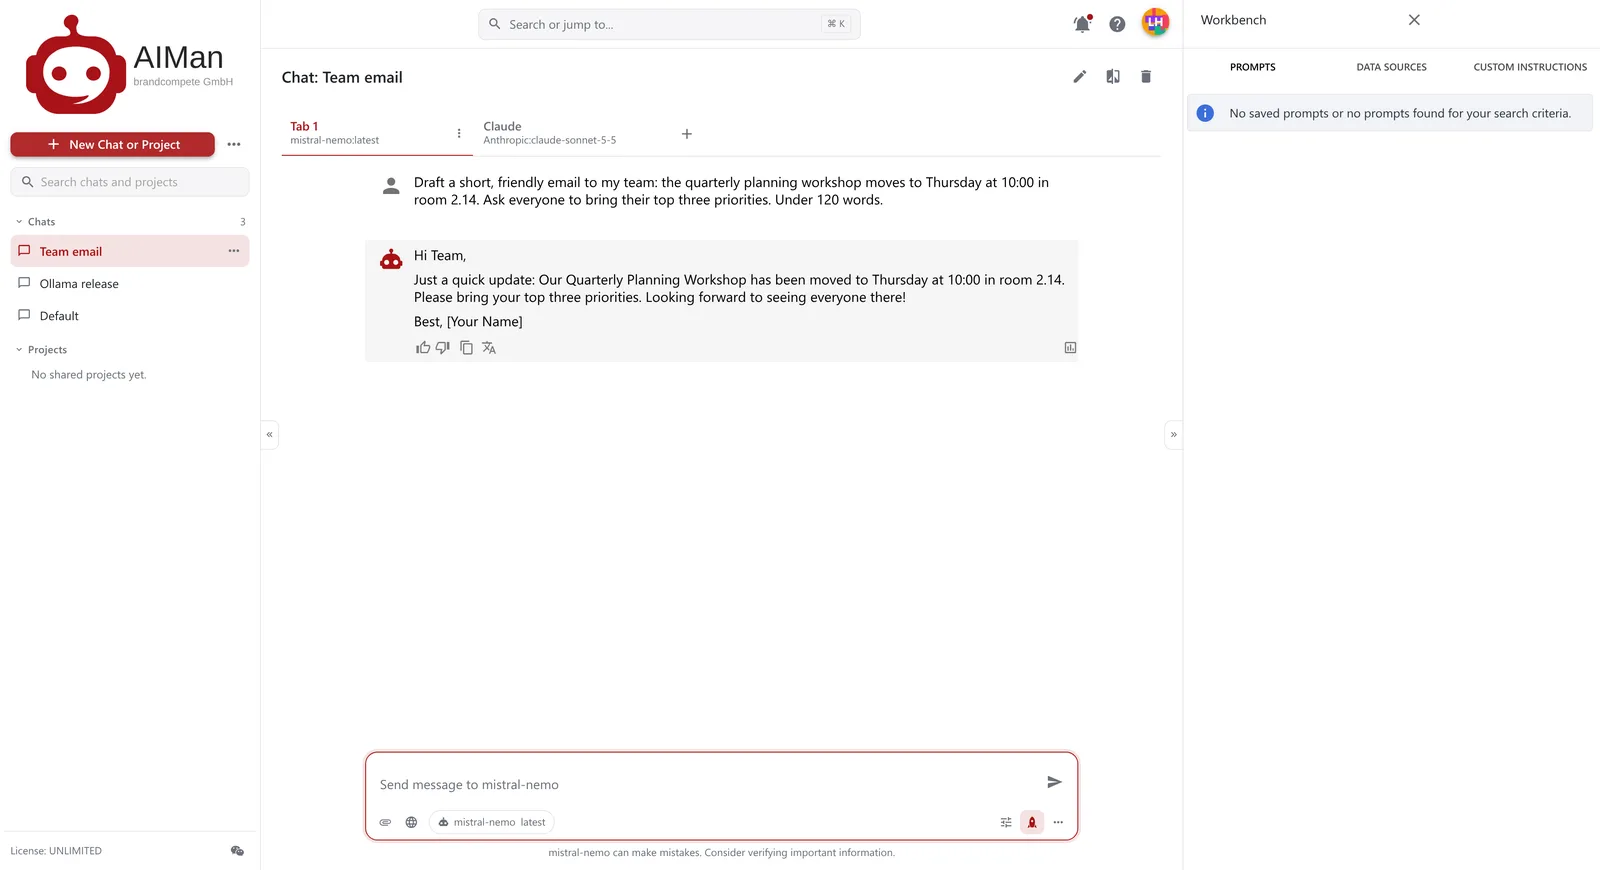
Gespeicherte Prompts, startklar.
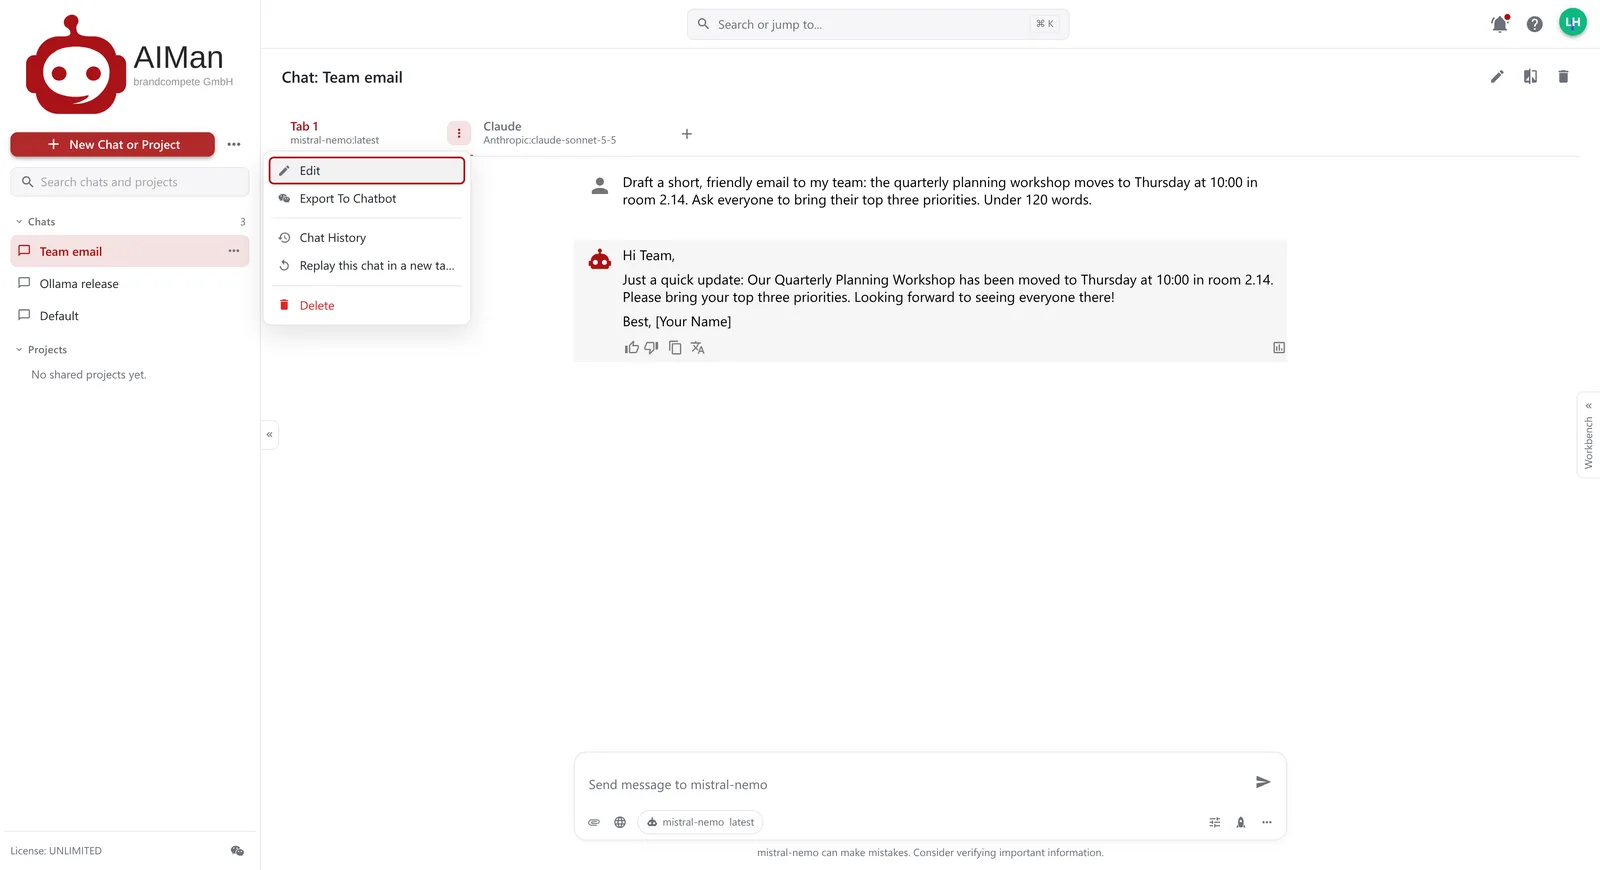
Als Chatbot exportieren, wiederholen, Verlauf.
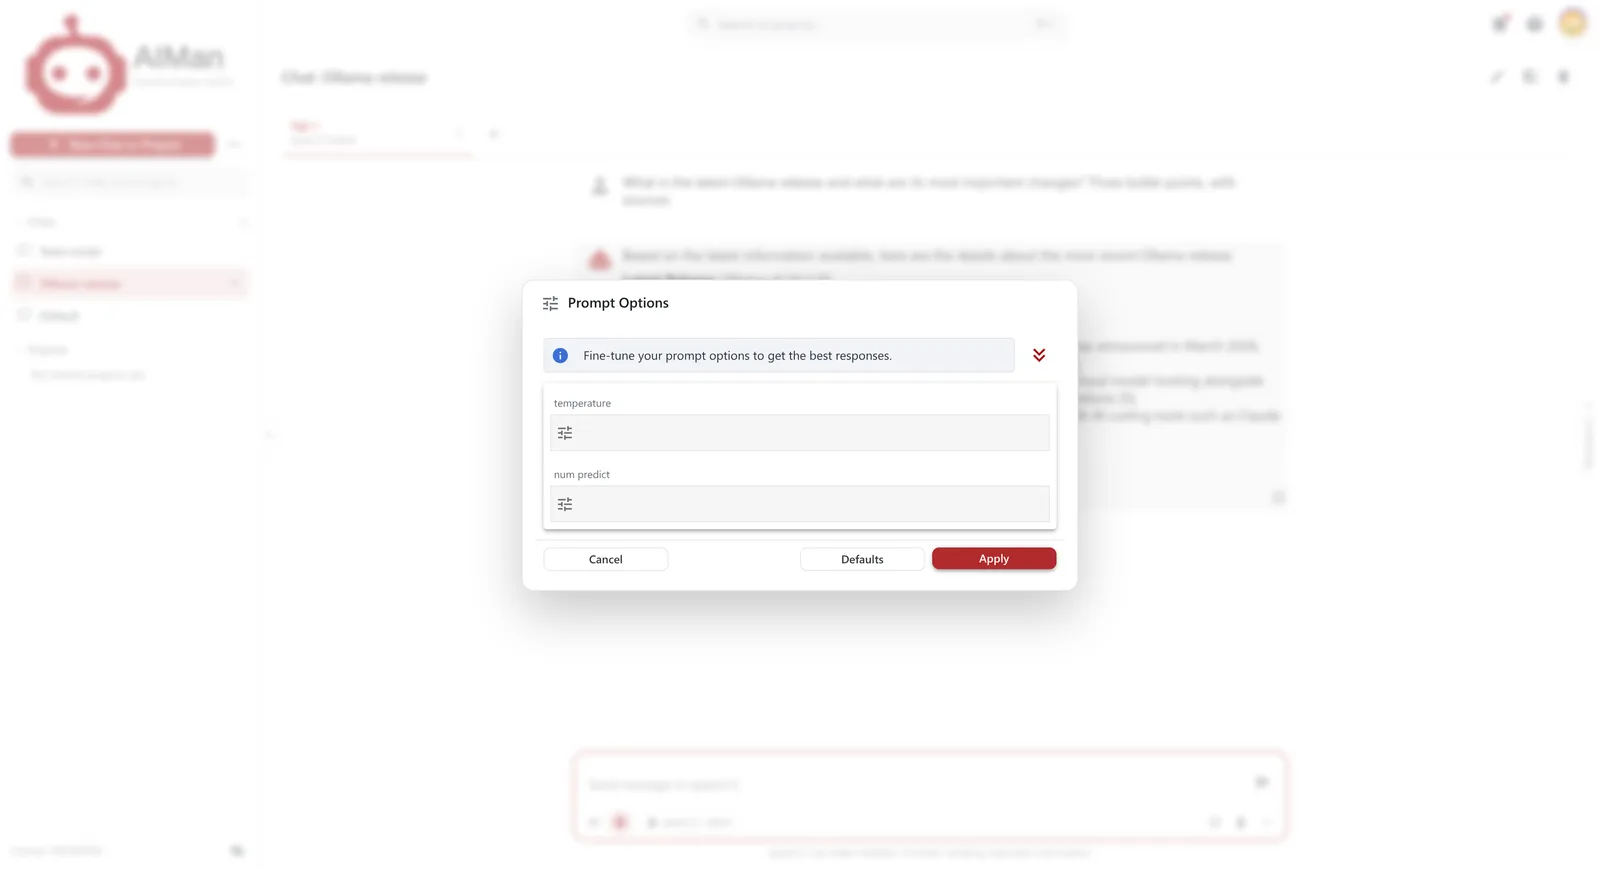
Temperatur und Länge fein einstellen.
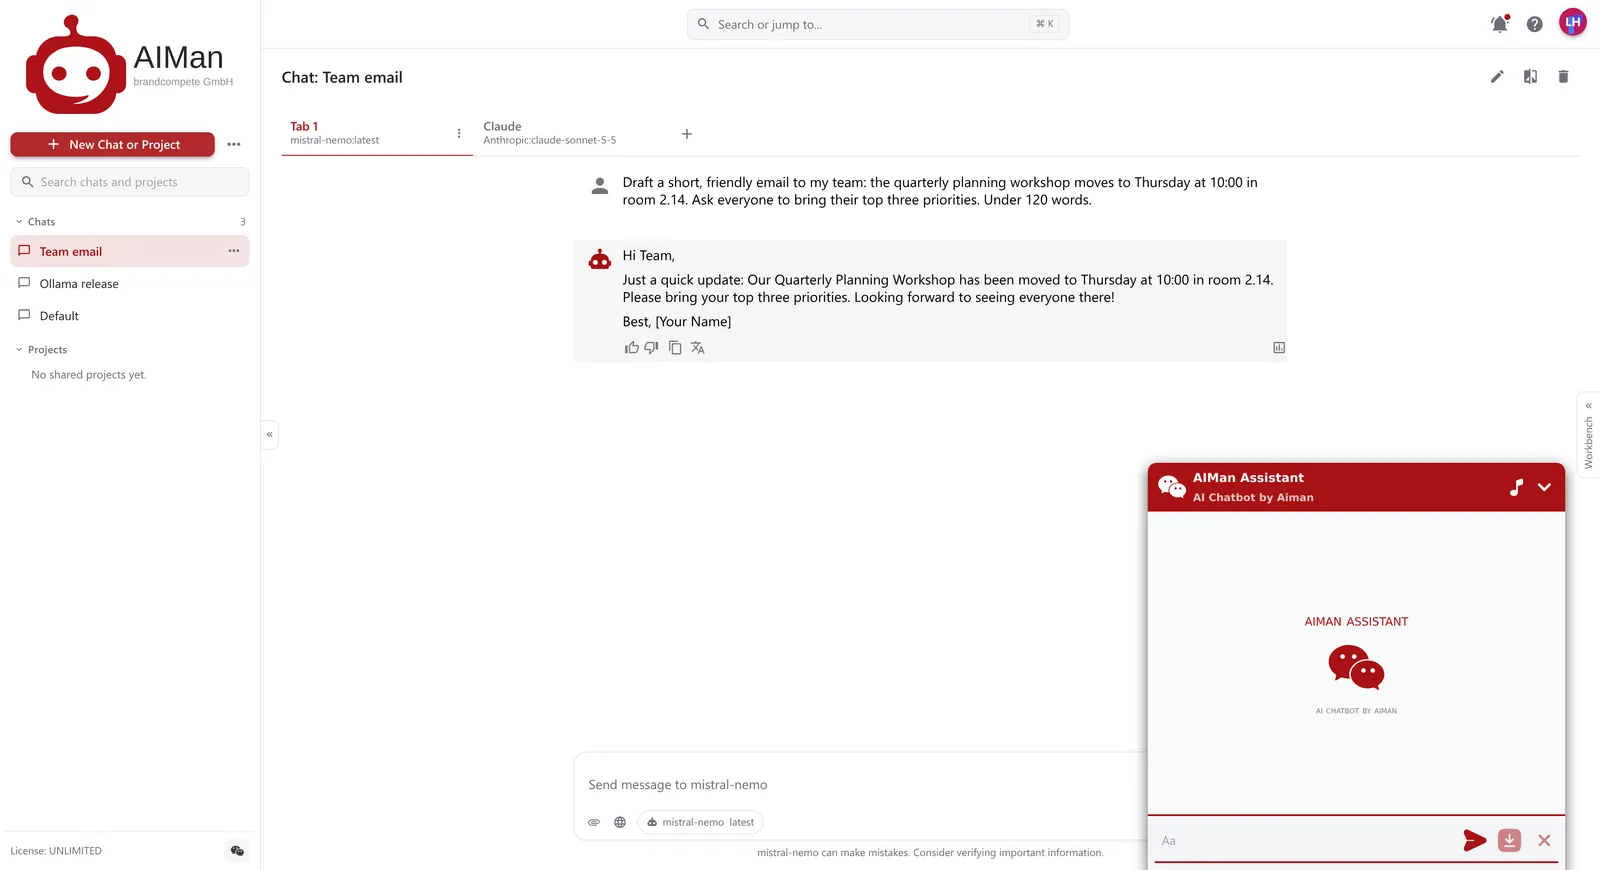
Jeder Chat-Tab — mit seinem Modell, seiner Datenquelle und seinen Anweisungen — lässt sich als Chatbot exportieren und mit wenigen Zeilen Code in eine Intranetseite oder eine Anwendung einbetten. AIMan nutzt das selbst: für den AIMan Assistant.
Admins legen fest, welche Modelle und Versionen das Unternehmen sieht und in welcher Reihenfolge, und schalten ein Modell mit einem Klick frei oder wieder ab. Eine Live-Ansicht zeigt, welche offenen Modelle auf welchem Server im GPU-Speicher liegen.
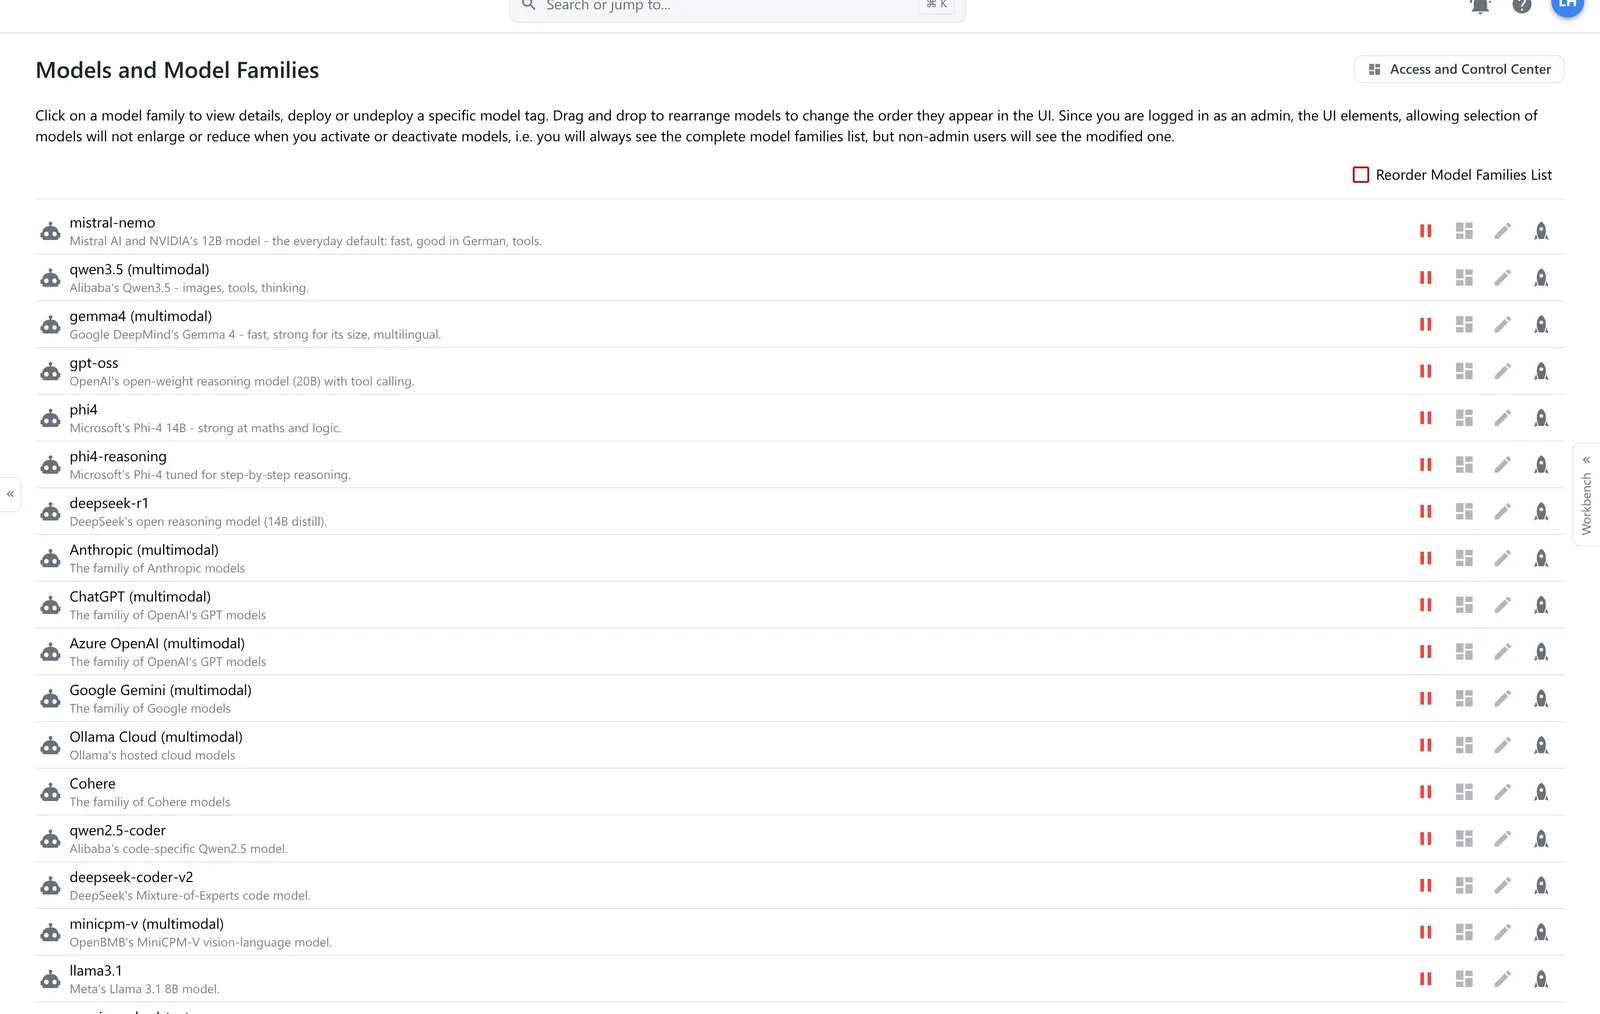
Modellfamilien, freigeschaltet oder nicht.
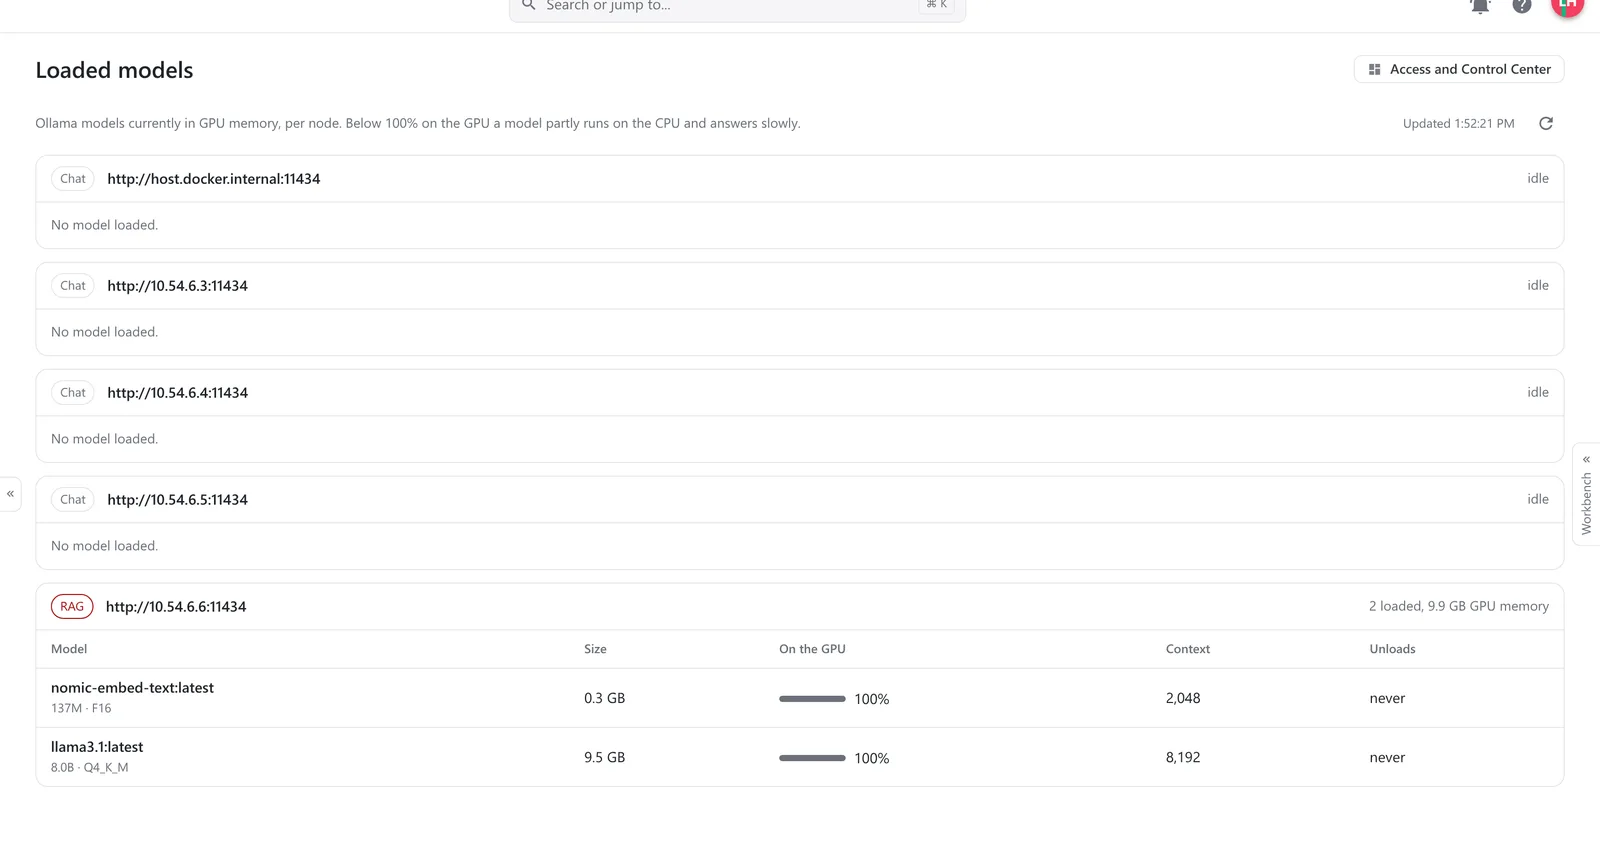
Was auf welchem GPU-Server geladen ist.
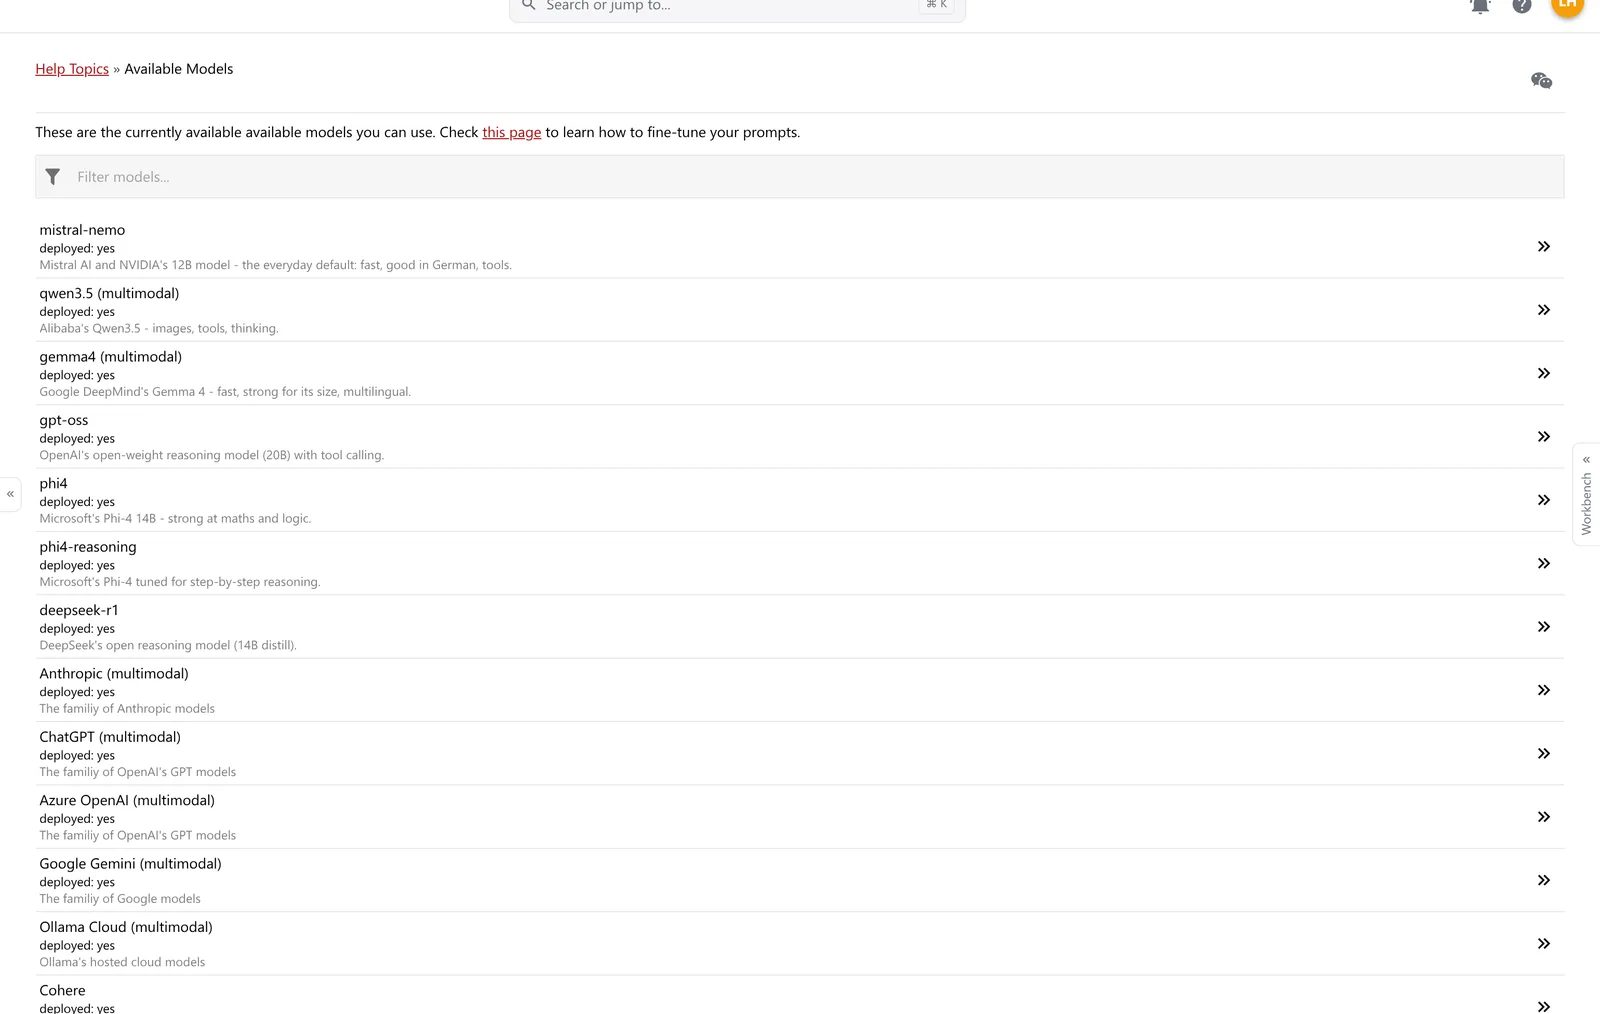
Jedes Modell, für Nutzer erklärt.
Im Access and Control Center findet die IT alles, was sie braucht: Konten und Rollen, die Organisationseinheiten und Teams, mit denen geteilt wird, die Anbieterschlüssel, unter denen jeder Modellaufruf läuft, und die Anweisungen, die jedes Modell erhält.
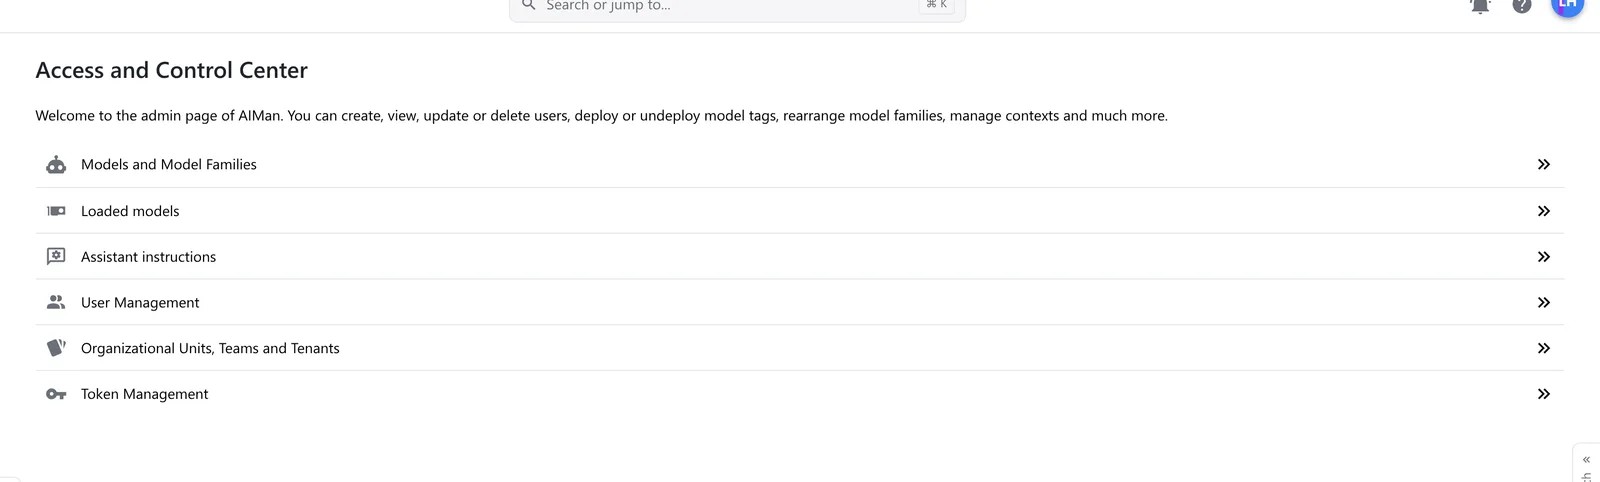
Das Access and Control Center.
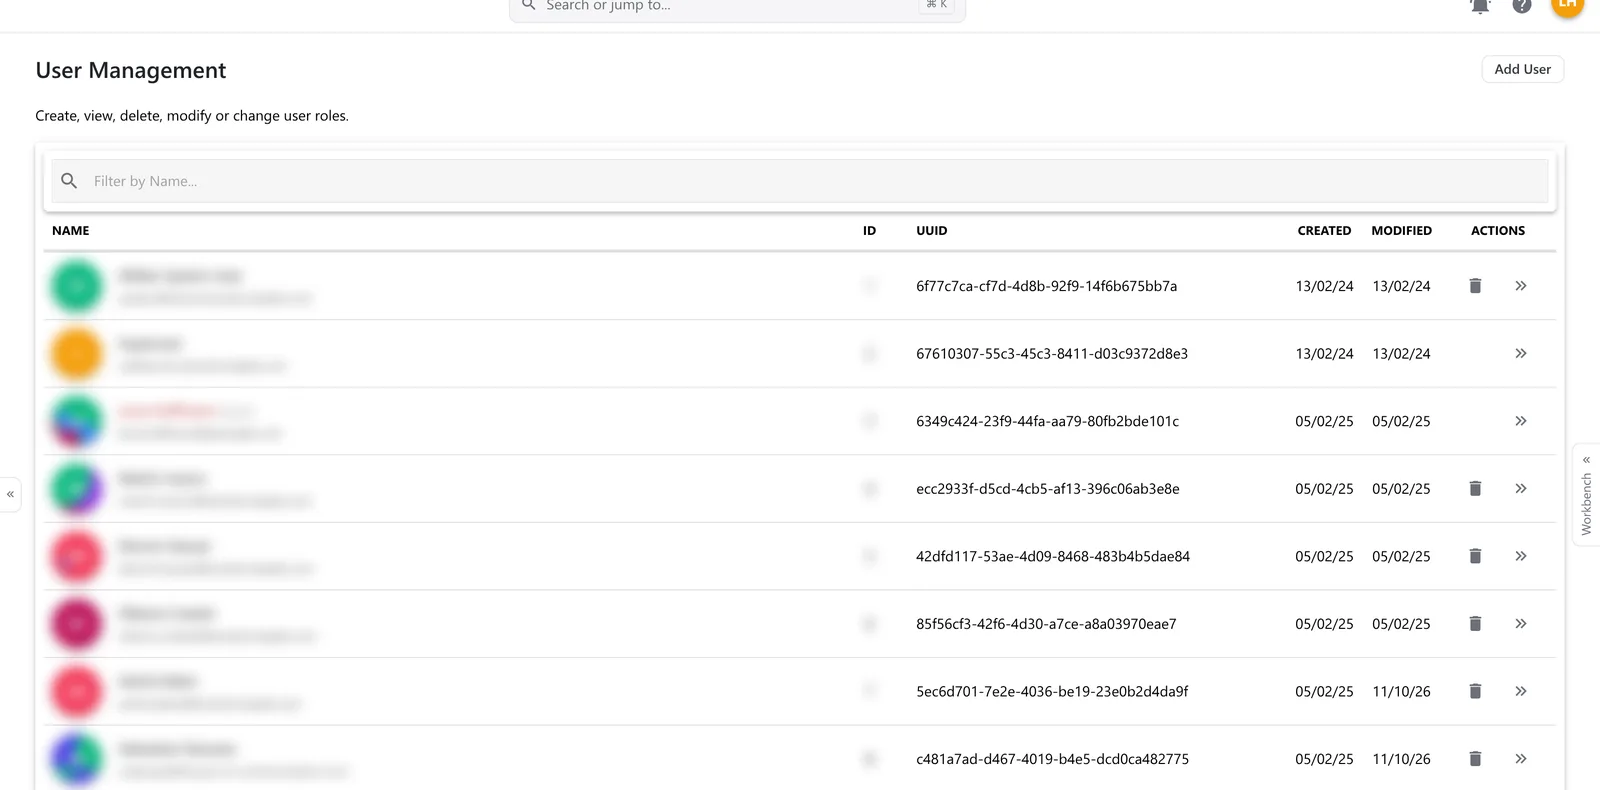
Konten und Rollen (Namen von uns unkenntlich gemacht).
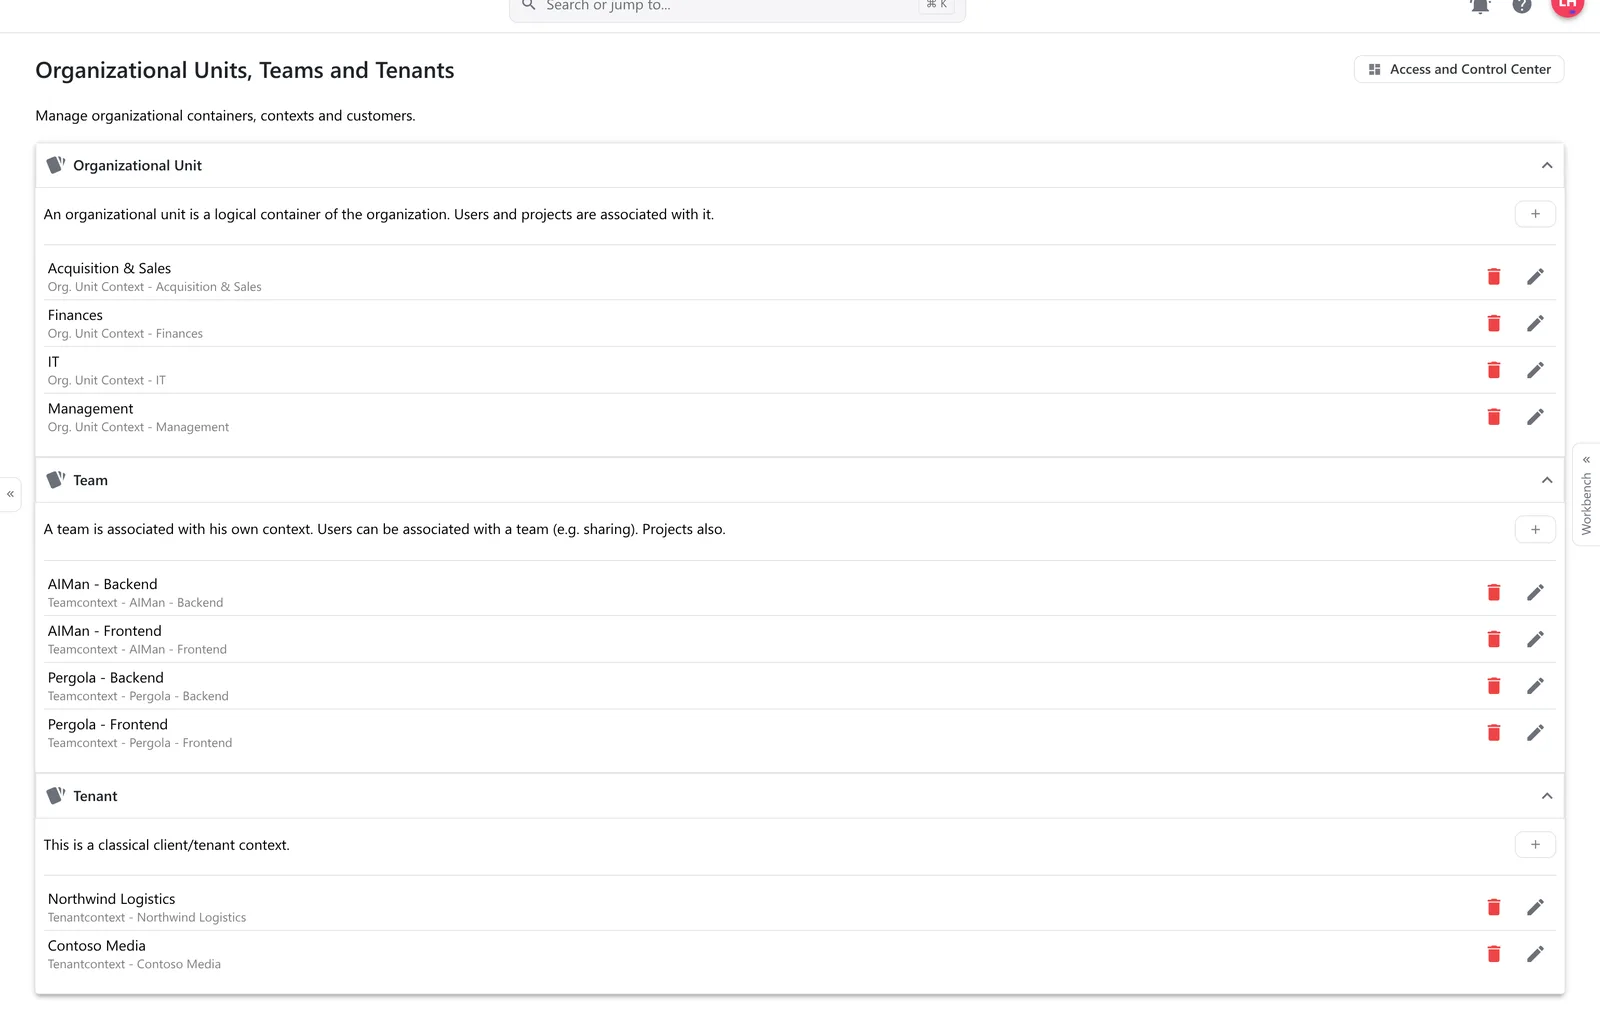
Organisationseinheiten, Teams, Mandanten.
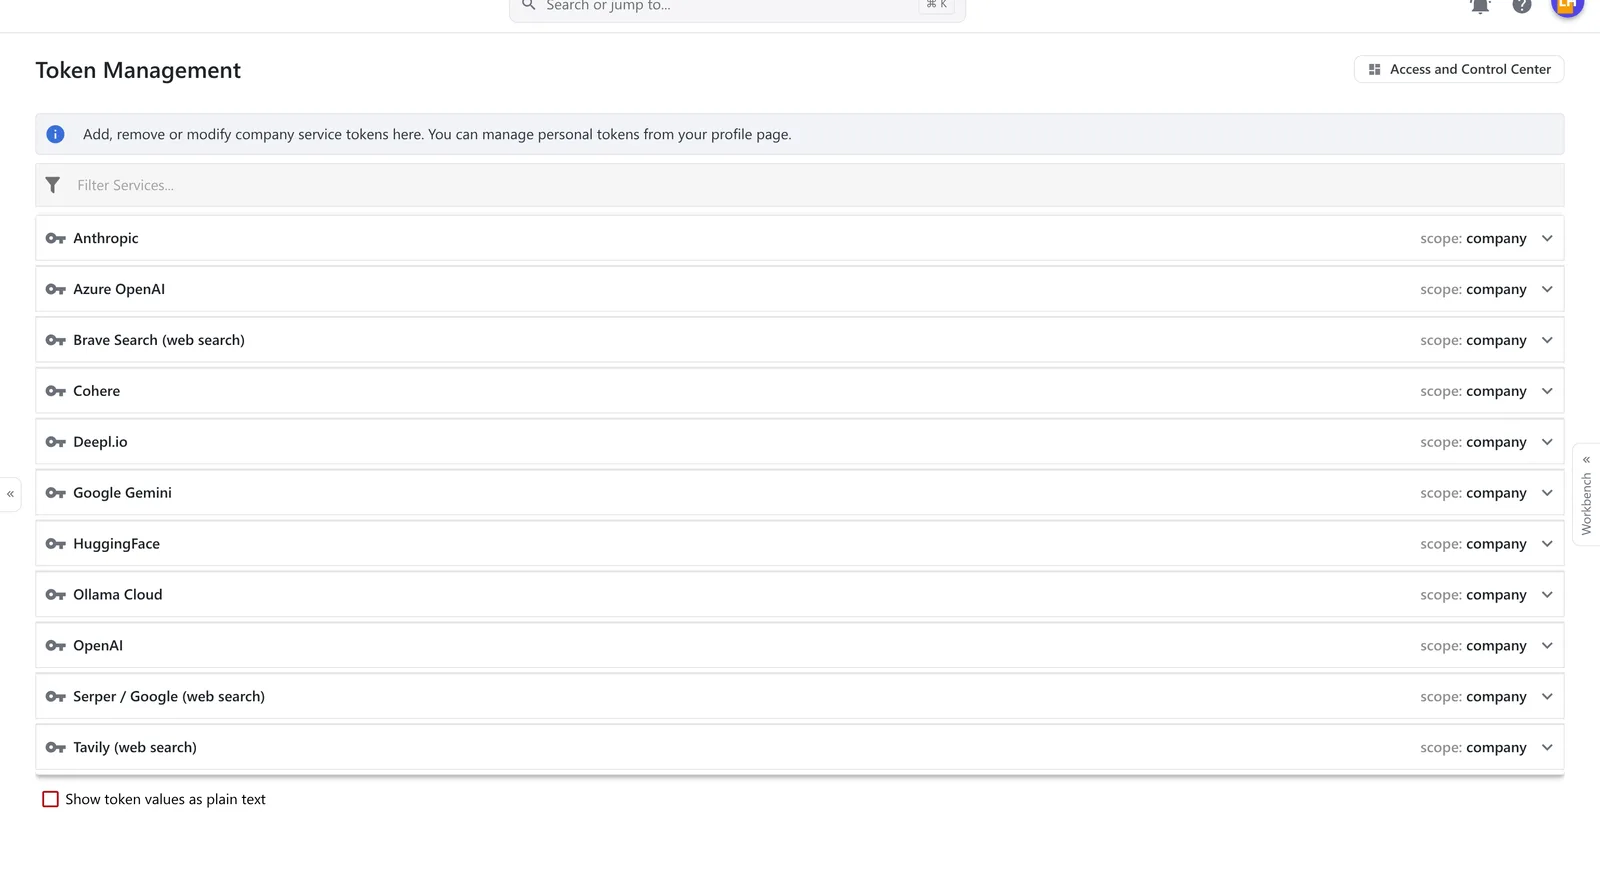
Anbieterschlüssel, zentral verwahrt.
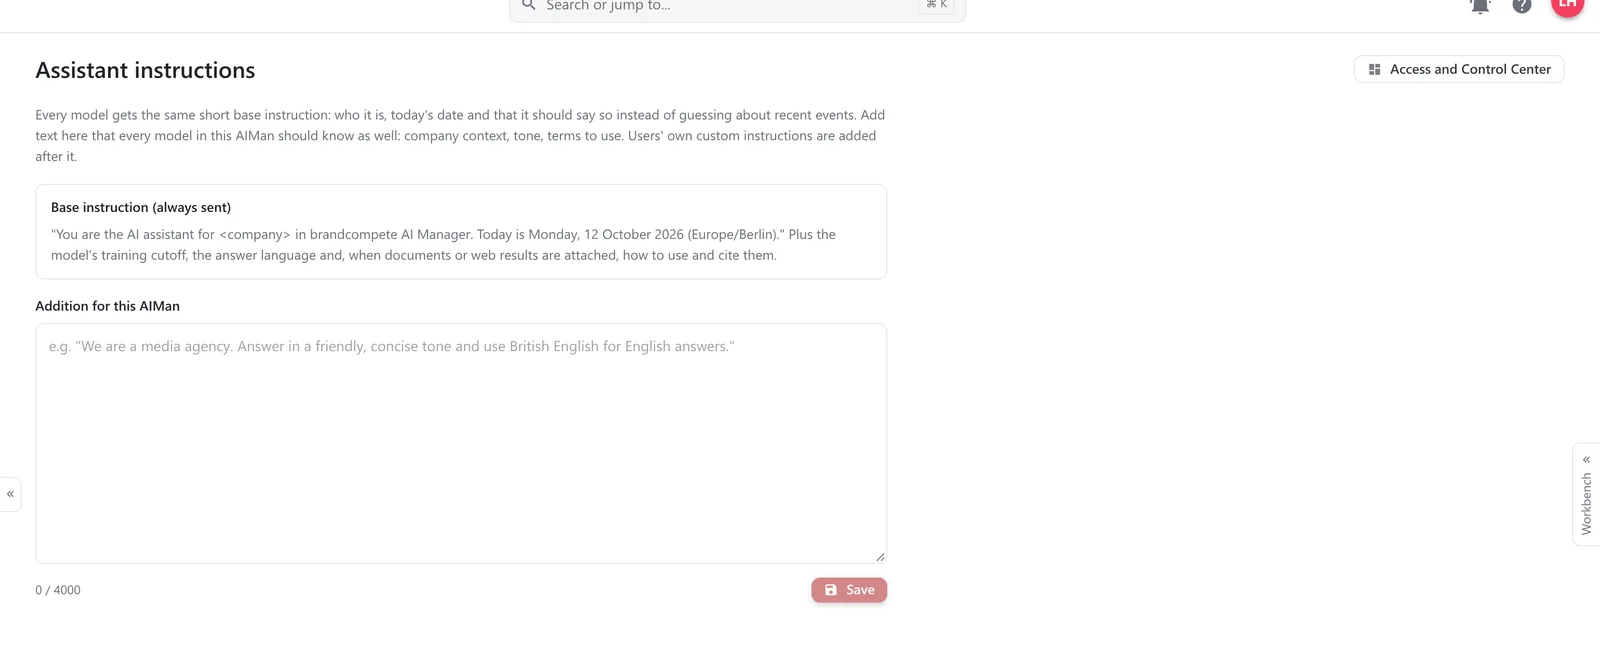
Was jedes Modell wissen sollte.
Ihre Mitarbeitenden melden sich mit ihrem Microsoft- oder Google-Arbeitskonto an oder mit E-Mail und Passwort. Zugang erhalten nur die Domains und Verzeichnisse, die das Unternehmen festlegt — und jede Installation trägt die Farben und das Logo des Unternehmens.
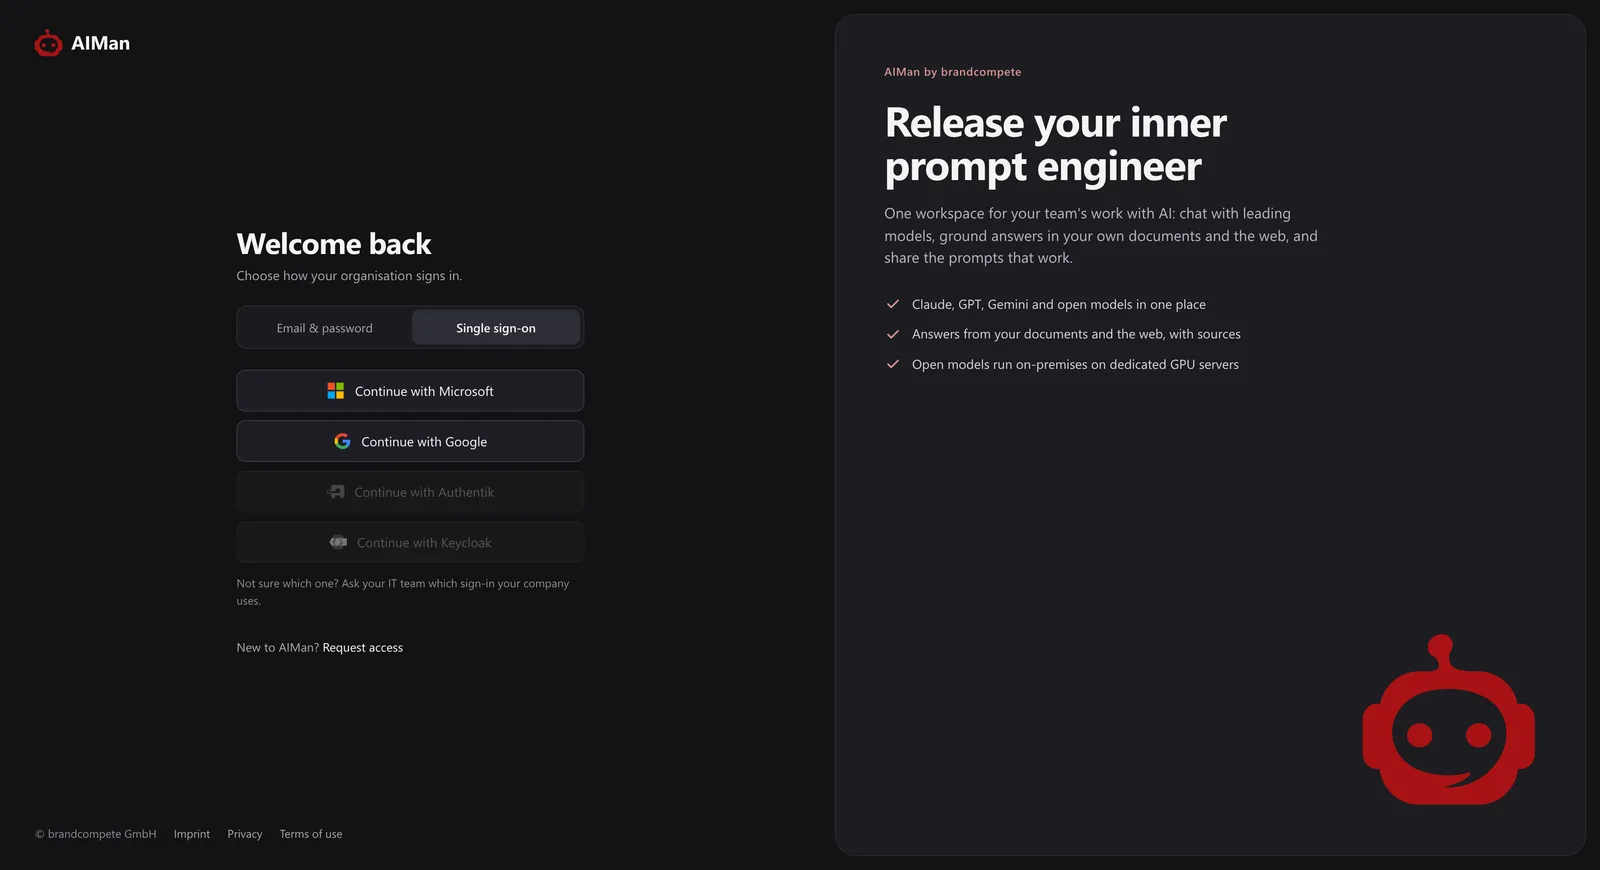
Microsoft oder Google, ein Klick.
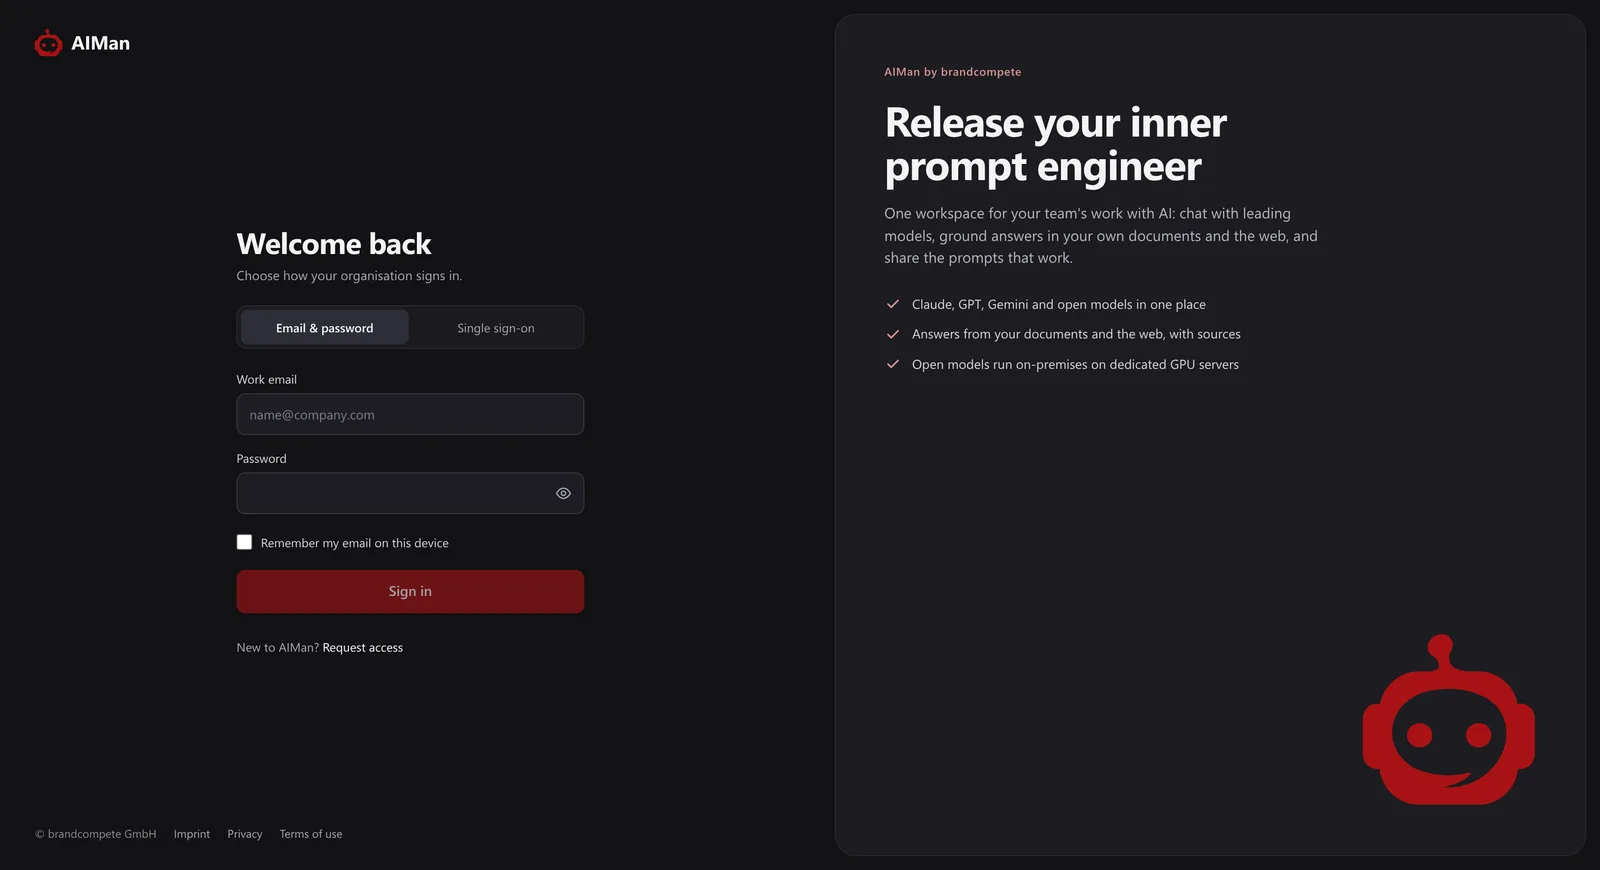
Oder mit E-Mail und Passwort.
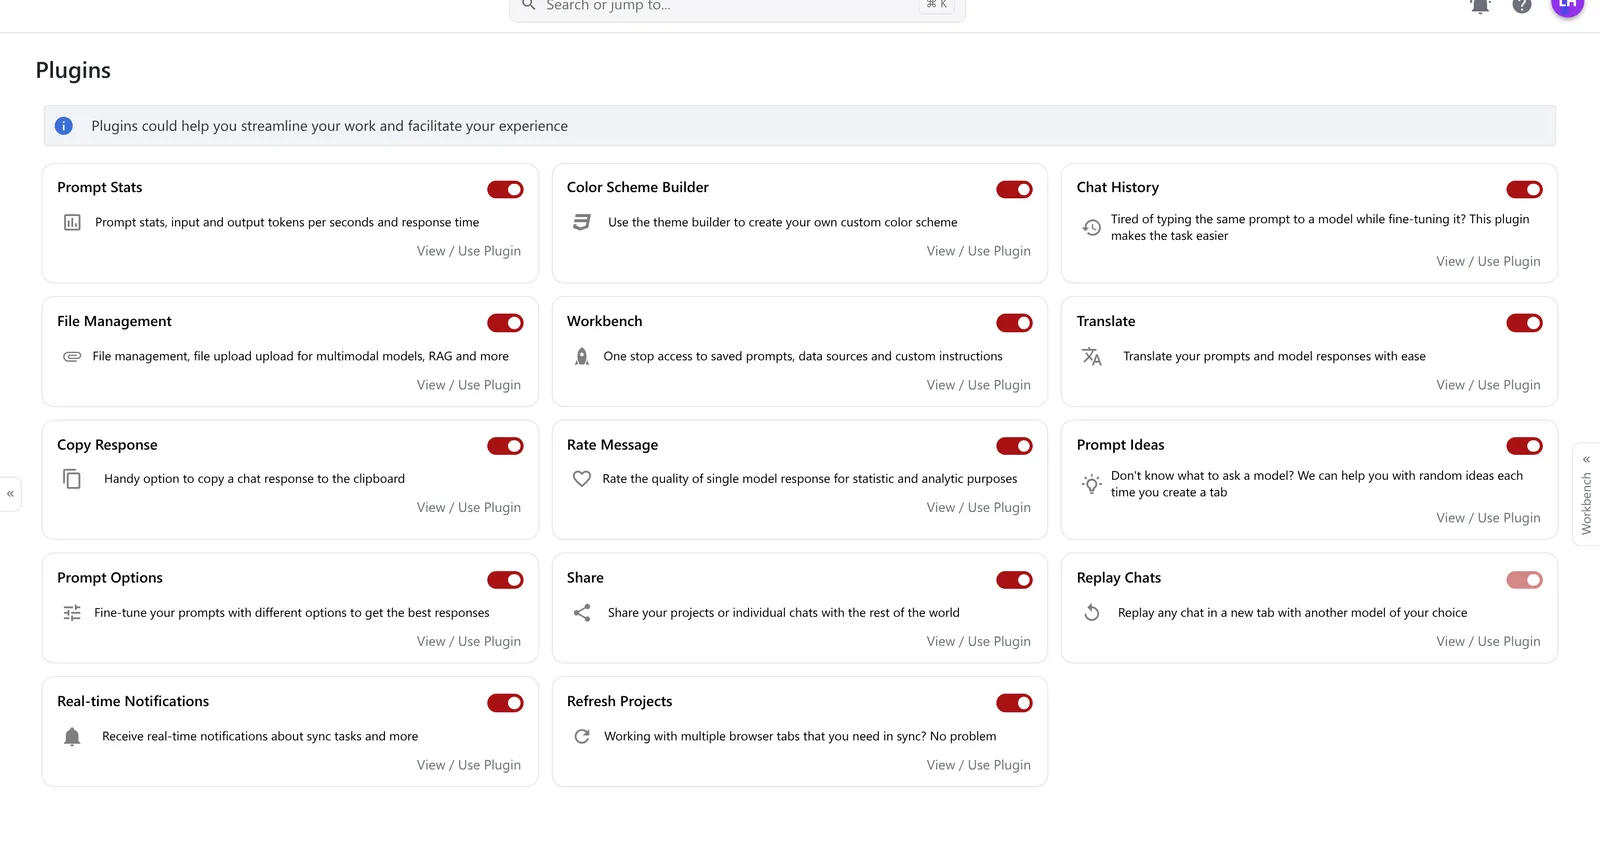
Übersetzung, Prompt-Statistiken, Chatverlauf, Teilen, Bewerten und mehr sind Plugins, die jede Person für sich ein- oder ausschaltet — so bleibt die Oberfläche so einfach wie die Aufgabe.
Eine Plattform, drei Gewinner
Sicherheit & Architektur
Eine Spring-Boot-API, ein Web-Frontend, PostgreSQL, ein eigener Retrieval-Dienst und Ollama auf dedizierten GPU-Servern — jeder Kunde in einer eigenen Installation.
Microsoft Entra ID und Google, beschränkt auf die E-Mail-Domains und Verzeichnisse, die Sie festlegen. Eine leere Liste lässt niemanden herein.
Lokale Modelle und Anbietermodelle stehen in getrennten Reitern der Auswahl — so sieht jeder, wohin ein Prompt geht.
Prompts, Antworten und Textstellen für offene Modelle werden auf dedizierten GPU-Servern in Deutschland verarbeitet — oder auf Ihren.
Indexierung, Embeddings und Reranking laufen für jedes Modell auf unseren eigenen Servern; an ein Anbietermodell gehen nur die Textstellen, die eine Antwort braucht.
Jeder Kunde hat eine eigene Datenbank, einen eigenen Suchindex, eine eigene Warteschlange und ein eigenes Netzwerk. Gemeinsam genutzt werden nur die GPUs.
Anbieter- und Suchschlüssel werden einmal pro Unternehmen hinterlegt und auf dem Server verwendet. Ihre Werte bleiben verborgen, bis ein Admin sie anfordert.
Rollen legen fest, was jemand anlegen und verwalten darf. Alles bleibt privat, bis es geteilt wird — mit Personen, Teams oder Einheiten, zum Lesen, Schreiben oder Verwalten.
Ein Konto kann die Oberfläche, die API oder beides nutzen dürfen — ein Dienstkonto bekommt also nie ein Chatfenster.
Abgerufen werden nur öffentliche Adressen, jede Weiterleitung wird geprüft, und Inhalte aus dem Web gelten als Information, nie als Anweisung.
Jedes Modell kennt das heutige Datum und ist angewiesen zu sagen, wenn es etwas nicht wissen kann. Keine passende Textstelle? Dann sagt AIMan das.
Modellantworten werden vor der Anzeige bereinigt, damit eine präparierte Antwort keinen Code im Browser ausführen kann.
Nur der Web-Zugang ist von außen erreichbar. Datenbank, Retrieval-Dienst und GPU-Knoten liegen ausschließlich in privaten Netzen.
Betrieb
Immer eine Installation nur für Sie. Der Unterschied liegt darin, wo sie läuft und wer sie betreibt.
Der Preis hängt vom Betriebsmodell und von der Größe der Installation ab — fragen Sie uns nach einer Zahl. Anbietermodelle laufen mit den eigenen Schlüsseln Ihres Unternehmens und werden vom Anbieter direkt mit Ihnen abgerechnet.
Roadmap
Was heute geht, was als Nächstes kommt und was weiter entfernt ist — klar benannt, damit Sie einen Pilot auf Fakten planen.
Heute verfügbar
Als Nächstes
Später
Pilotangebot
Eine Abteilung, echte Aufgaben, Ihre eigenen Dokumente — und nach wenigen Wochen eine Entscheidung auf Basis von Belegen statt einer Demo.
Ihre Installation mit Ihrem Single Sign-on, Ihrem Corporate Design, den Modellen Ihrer Wahl und einer ersten angebundenen Wissensbasis.
Eine Abteilung arbeitet jeden Tag damit — mit ihren eigenen Dokumenten und Fragen, begleitet von einem kurzen wöchentlichen Austausch.
Ein Bericht über Nutzung, Modelle und Feedback — und ein Plan für den Rollout, wenn Sie weitergehen wollen.
Fragen
AIMan ist ein KI-Arbeitsbereich für das ganze Unternehmen. Alle melden sich einmal an und chatten in derselben Oberfläche mit den führenden gehosteten Modellen — Claude, GPT, Gemini, Cohere — und mit offenen Modellen, die auf dedizierten GPU-Servern in Deutschland laufen. Antworten können aus Ihren eigenen Dokumenten, Webseiten und Wikis stammen oder aus aktuellen Web-Ergebnissen, jeweils mit Quellenangabe. Die IT legt fest, welche Modelle angeboten werden und wer was nutzen darf, und verwahrt die Anbieterschlüssel zentral. So braucht niemand ein privates Konto, um mit KI zu arbeiten.
Zwei Arten, in einer Auswahl. Offene Modelle laufen auf unseren eigenen GPU-Servern: Mistral NeMo (der Standard — schnell und stark im Deutschen), Qwen 3.5 und Gemma 4 mit Bildeingabe, gpt-oss, Phi-4 und Phi-4-reasoning, DeepSeek-R1, Llama 3.1, zwei Code-Modelle und ein Vision-Modell. Anbietermodelle laufen beim jeweiligen Anbieter unter dem Schlüssel Ihres Unternehmens: Anthropic Claude, OpenAI GPT, Azure OpenAI, Google Gemini, Cohere und Ollama Cloud. Admins entscheiden, welche Familien und Versionen sichtbar sind; neue Modelle kommen hinzu, sobald sie erscheinen.
Das hängt vom gewählten Modell ab — und AIMan macht diese Wahl sichtbar: Lokale Modelle und Anbietermodelle stehen in getrennten Reitern der Auswahl. Bei einem offenen Modell bleiben Prompt, Antwort und alle Dokumentstellen auf den dedizierten GPU-Servern von brandcompete in Deutschland oder, wenn Sie AIMan on-premise betreiben, auf Ihren eigenen Servern. Die gesamte Dokumentverarbeitung — Einlesen, Indexieren, Suchen und Reranking — läuft ebenfalls dort, ganz gleich, welches Modell antwortet. Bei einem Anbietermodell gehen der Prompt und die benötigten Textstellen unter dem Vertrag und dem Schlüssel Ihres Unternehmens an diesen Anbieter. Übersetzungen gehen an DeepL, und die Websuche schickt eine Suchanfrage an einen Suchdienst. Jeder Kunde hat eine eigene Installation mit eigener Datenbank.
Sie legen eine Datenquelle an — hochgeladene Dateien, Webseiten oder ein angebundenes Confluence, Jira oder Bitbucket — und verknüpfen sie mit einem Chat oder einem Projekt. AIMan zerlegt die Dokumente in Textstellen und indexiert sie nach Bedeutung und nach Stichworten. Zu jeder Frage wählt es die passendsten Textstellen aus, sortiert sie mit einem Reranking neu und gibt sie dem Modell mit der Anweisung, sie zu zitieren. Die Antwort trägt nummerierte Verweise auf Dokument und Seite. Findet sich nichts Passendes, sagt AIMan das, statt das Modell raten zu lassen. Sie können einen Chat auch auf die Dokumente allein beschränken. Unterstützt werden PDF, Word, PowerPoint, Excel, Text, Markdown, HTML und CSV; gescannte PDFs ohne Textebene werden noch nicht gelesen.
Ja, wenn für den Chat die Websuche eingeschaltet ist. Claude, Gemini und GPT nutzen dann die Suche ihres Anbieters; offene Modelle suchen über AIMan, das die besten Seiten liest und gewichtet, bevor das Modell antwortet. In beiden Fällen nennt die Antwort ihre Quellen. Außerdem kennt jedes Modell das heutige Datum und weiß, was es nicht wissen kann — ohne Websuche sagt es also, wenn eine Frage über sein Trainingswissen hinausgeht, statt zu raten. Admins können die Websuche für eine Installation abschalten.
Ein Projekt ist ein gemeinsamer Chat: Kolleginnen und Kollegen, Teams oder eine ganze Organisationseinheit arbeiten darin zusammen, jeder Tab mit eigenem Modell und eigener Datenquelle. Bewährte Prompts kommen ins Prompt Repository, mit Platzhaltern für die Teile, die sich ändern, und lassen sich genauso teilen wie Datenquellen und Custom Instructions. Ein Chat-Tab lässt sich außerdem als Chatbot für eine Intranetseite oder eine Anwendung exportieren.
Angemeldet wird per Single Sign-on mit Microsoft Entra ID oder Google, beschränkt auf die E-Mail-Domains und Verzeichnisse, die Sie festlegen, oder mit E-Mail und Passwort. Jedes Konto hat eine Rolle, und Rollen tragen die Rechte: Chats, Datenquellen, Prompts oder Chatbots anlegen, Modelle, Benutzer oder Schlüssel verwalten. Was jemand anlegt, bleibt privat, bis er es mit bestimmten Kolleginnen und Kollegen, Teams, Organisationseinheiten oder dem ganzen Unternehmen teilt — zum Lesen, Schreiben oder Verwalten. Admins können einem Konto außerdem die Oberfläche, die API oder beides freigeben.
Ja. AIMan hat eine REST-API mit gestreamten Antworten, und jedes freigeschaltete Modell lässt sich per Name aufrufen — eine Anwendung kann also ohne Codeänderung von einem Modell zum anderen wechseln. Der API-Zugriff wird pro Konto eingestellt. Ein Chat-Tab lässt sich zudem als Chatbot in eine Website einbetten.
Auf drei Wegen. Als Managed Service betreibt brandcompete Ihre Installation auf seinen dedizierten GPU-Servern in deutschen Rechenzentren. On-Premise und betreut installiert und betreibt brandcompete AIMan in Ihrer eigenen Infrastruktur. On-Premise und selbst betrieben läuft AIMan unter Lizenz bei Ihrer IT, mit Releases und Support von brandcompete. In jedem Fall hat jeder Kunde eine eigene Installation mit eigener Datenbank, eigenem Suchindex und eigenem Netzwerk.
Das hängt davon ab, wie Sie AIMan betreiben und wie viele Personen es nutzen. Schreiben Sie an sales@brandcompete.com, und wir nennen Ihnen eine Zahl für Ihren Fall. Anbietermodelle nutzen Sie mit den eigenen Schlüsseln Ihres Unternehmens; deren Nutzung rechnet der Anbieter also direkt mit Ihnen ab, ohne Aufschlag von uns.
Mit einem Pilot. Etwa eine Woche, um Ihre Installation mit Ihrem Single Sign-on, Ihrem Corporate Design, den gewünschten Modellen und einer ersten Wissensbasis einzurichten; vier bis sechs Wochen, in denen eine Abteilung damit an echten Aufgaben arbeitet; danach etwa eine Woche für einen Nutzungsbericht und einen Rollout-Plan. Sie entscheiden aus Erfahrung, nicht nach einer Demo.
Material
Sie möchten die Vertriebspräsentation, einen technischen Deep Dive oder eine Live-Vorführung? Schreiben Sie uns, wir schicken sie Ihnen.
Erzählen Sie uns, welche Teams KI wollen und wofür — und wir zeigen Ihnen genau das, laufend mit Ihren eigenen Dokumenten.
Lieber per E-Mail? Schreiben Sie an sales@brandcompete.com.